Rubrique / 28 articles
Guides pratiques
Guides concrets, décryptages et méthodes directement applicables.
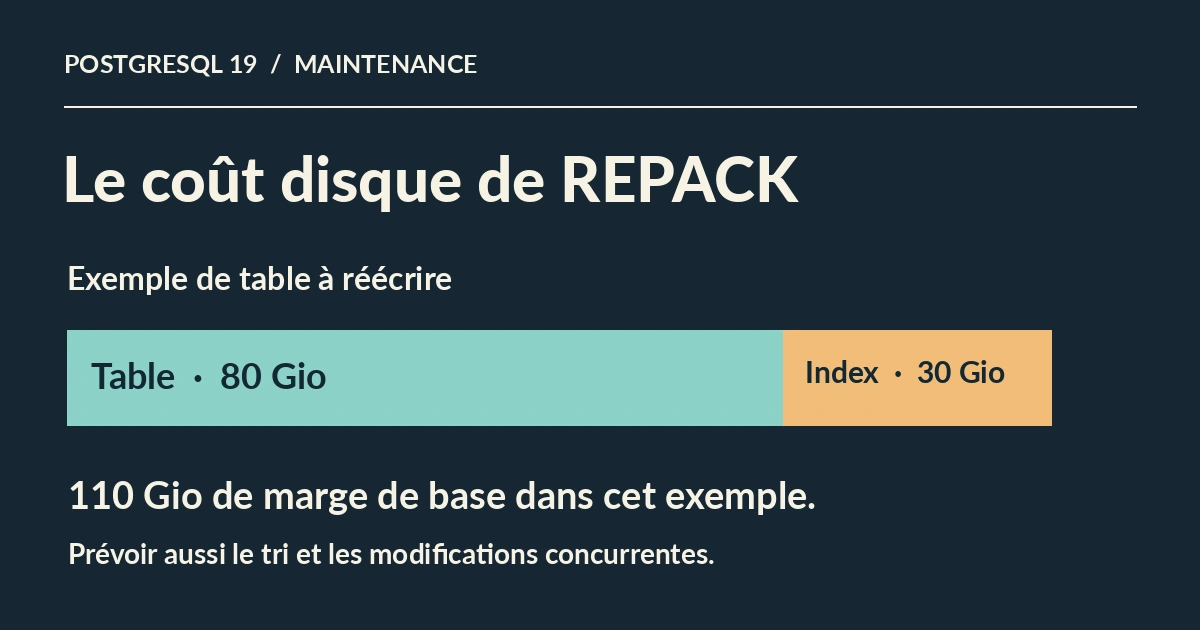
PostgreSQL 19, combien de disque faut-il pour compacter une table en service ?
Table, index, tri et verrou final : un exemple chiffré pour préparer un compactage concurrent sur PostgreSQL 19 et mesurer son effet sur le service.
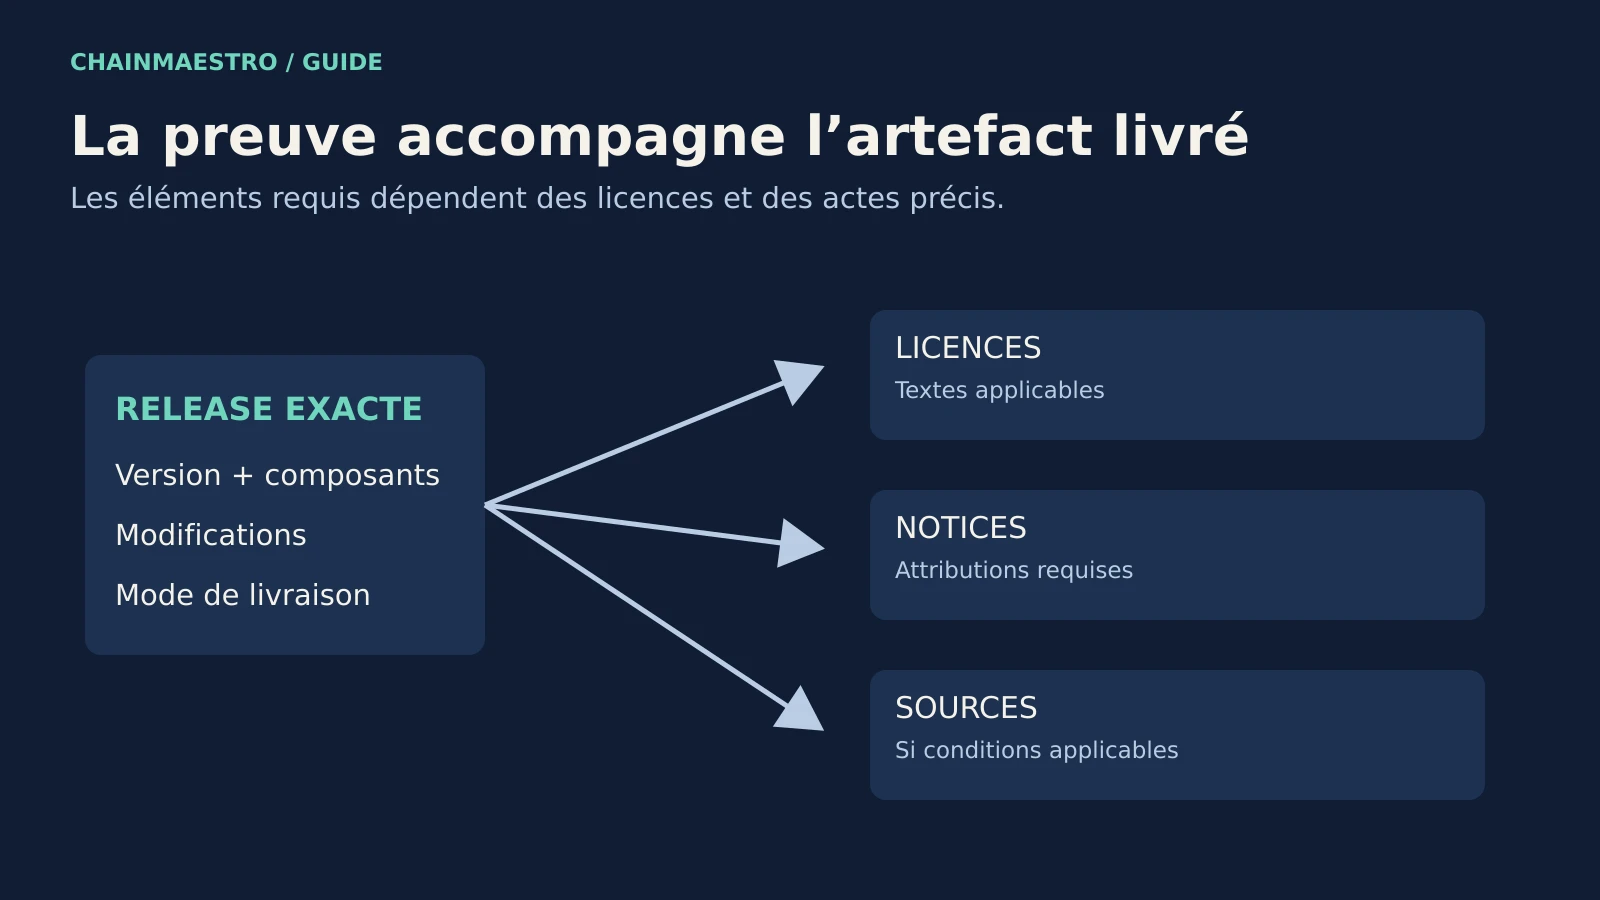
Licences open source : préparer les preuves avant de distribuer
Identifier versions, composants et mode de livraison, puis vérifier notices et sources correspondantes dans le paquet réellement distribué.
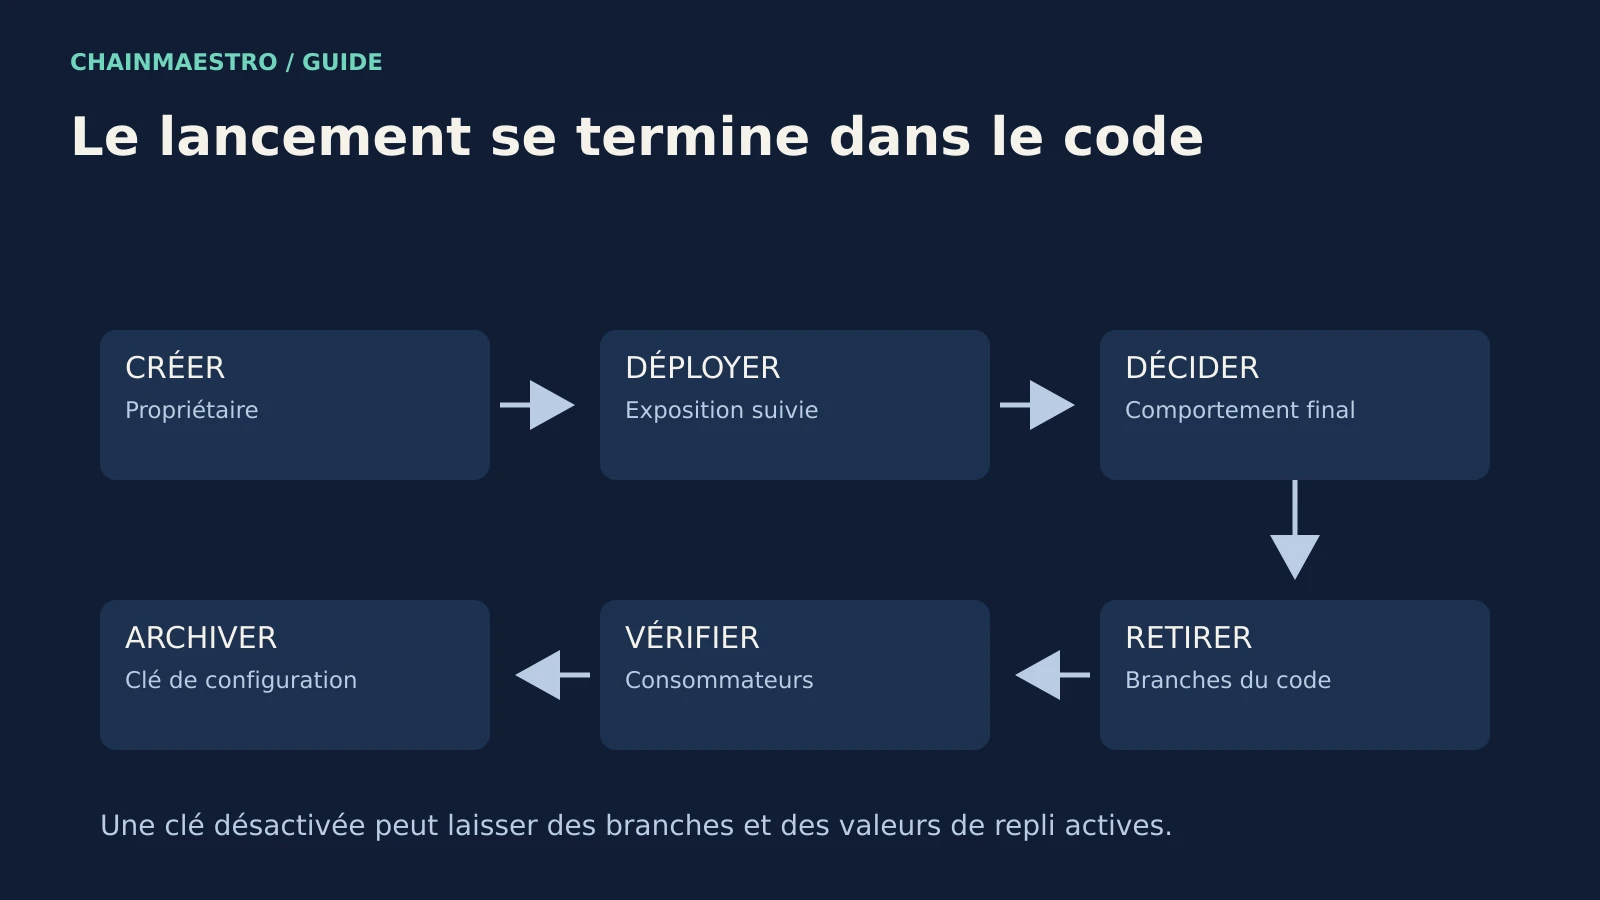
Feature flags : terminer le lancement et supprimer la dette
Propriétaire, valeur de repli, consommateurs et données : retirer un flag après la décision produit sans casser les versions encore actives.
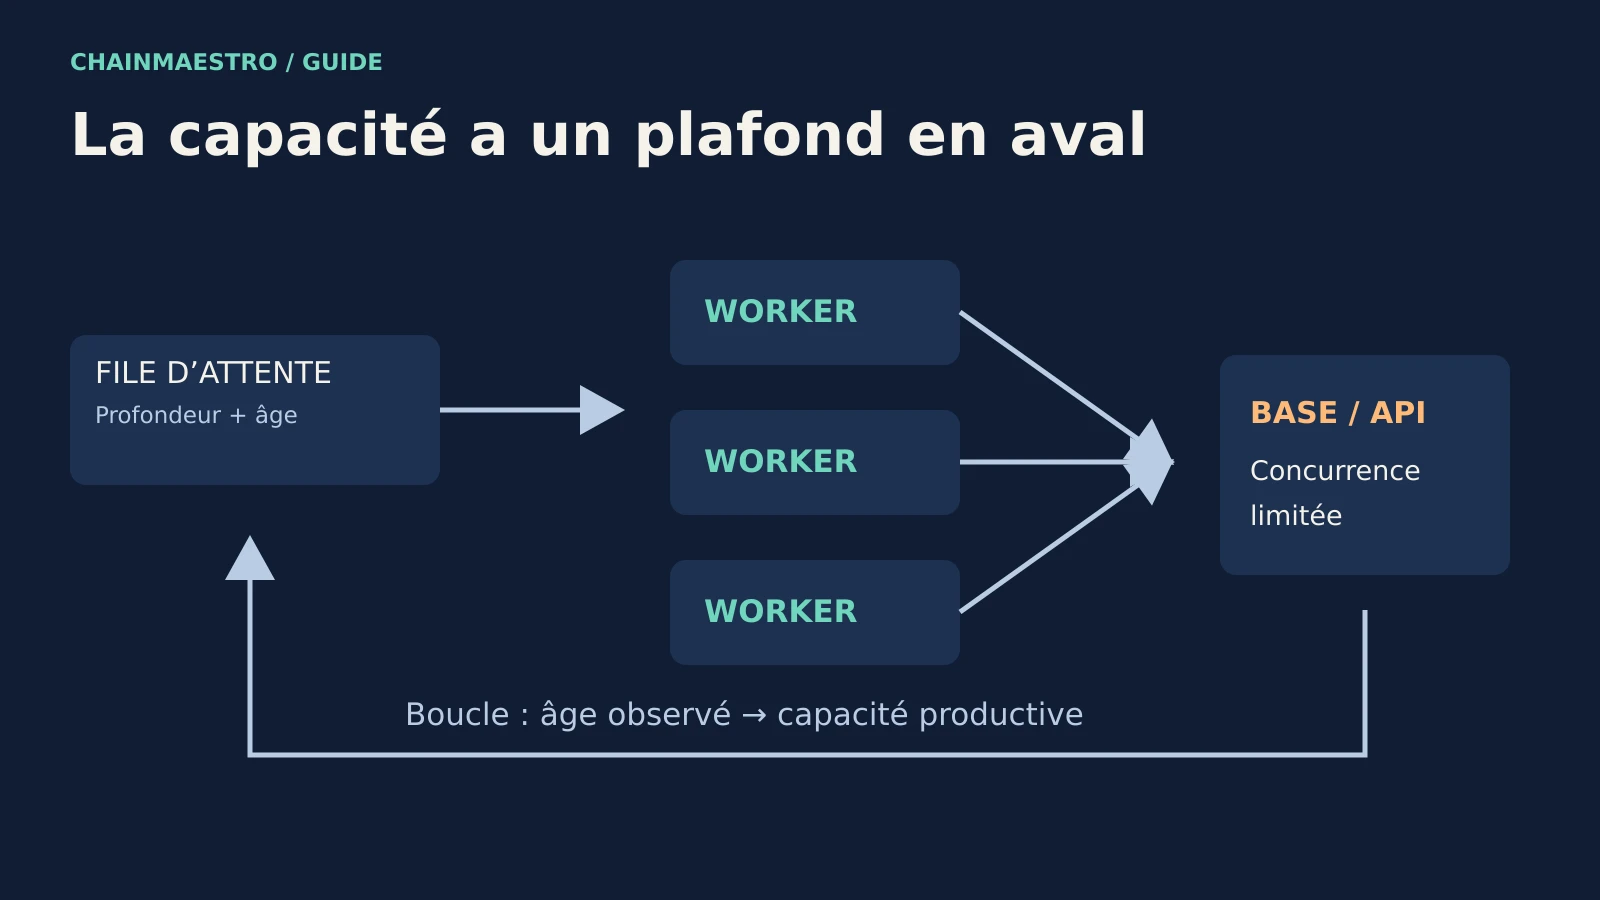
Autoscaling : piloter la file d’attente, le délai et le coût
Dimensionner les workers avec l’âge des tâches, la durée de traitement et la capacité de l’aval, puis tester les montées et les arrêts.
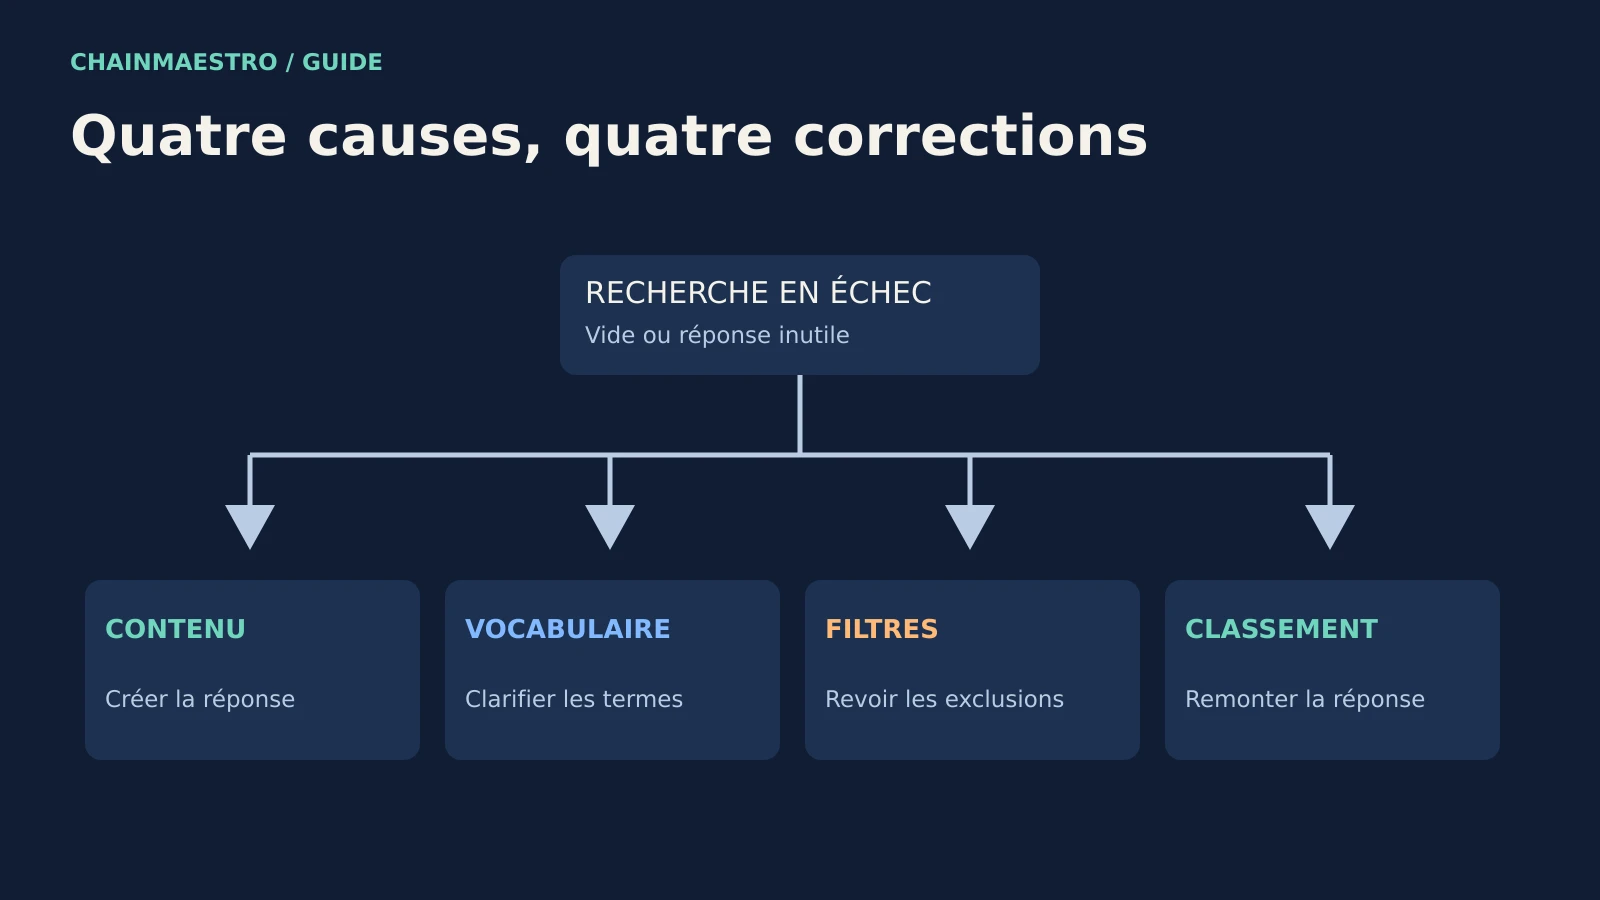
Recherche interne : lire au-delà du taux de zéro résultat
Distinguer contenu absent, vocabulaire, filtres et classement pour améliorer la recherche interne sans masquer les échecs par des réponses inutiles.
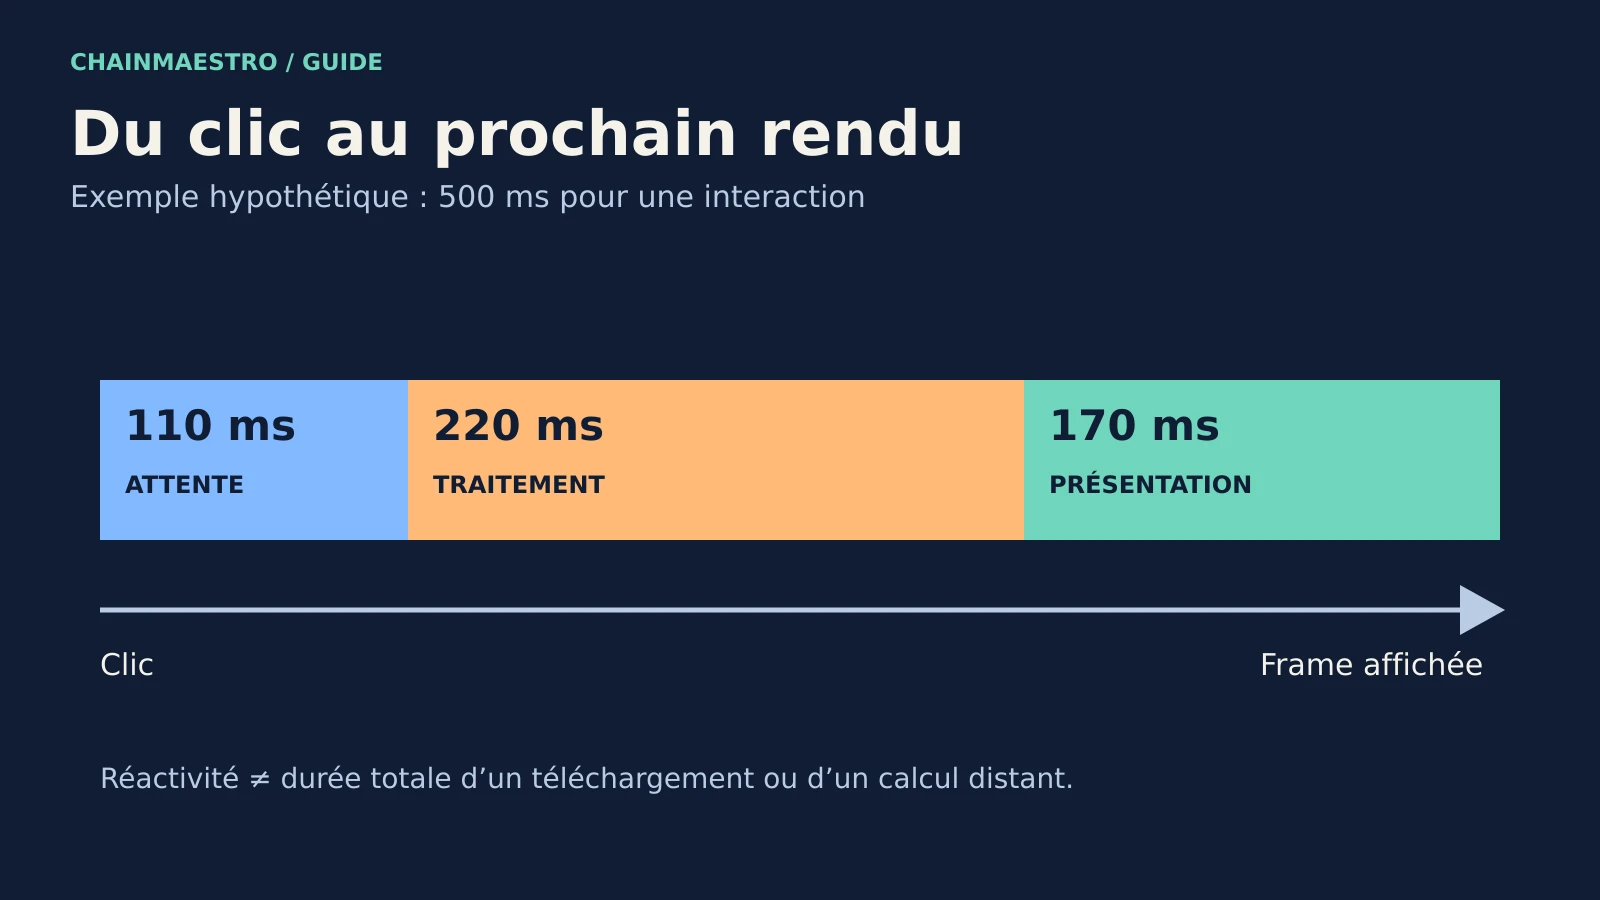
INP : diagnostiquer une interaction lente, du clic au rendu
Séparer attente, traitement et présentation pour corriger les interactions lentes, avec des données de terrain et une trace reproductible.
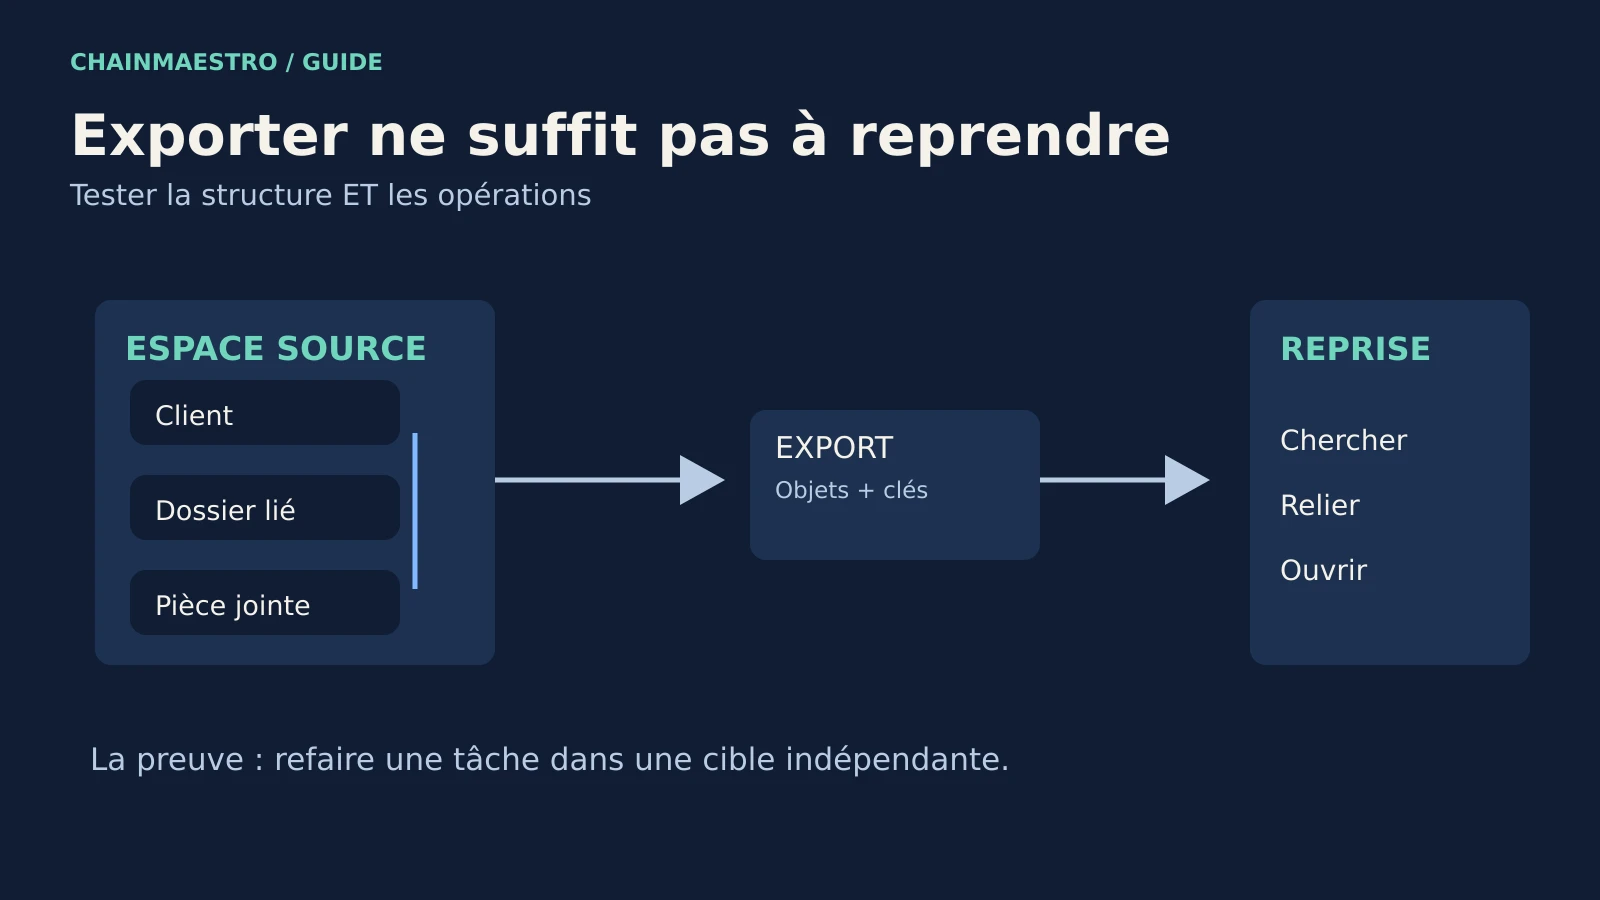
Choisir un SaaS : vérifier la sortie avant de signer
Tester relations, documents, droits et automatisations sur un échantillon pour distinguer un export disponible d’une reprise réellement utilisable.
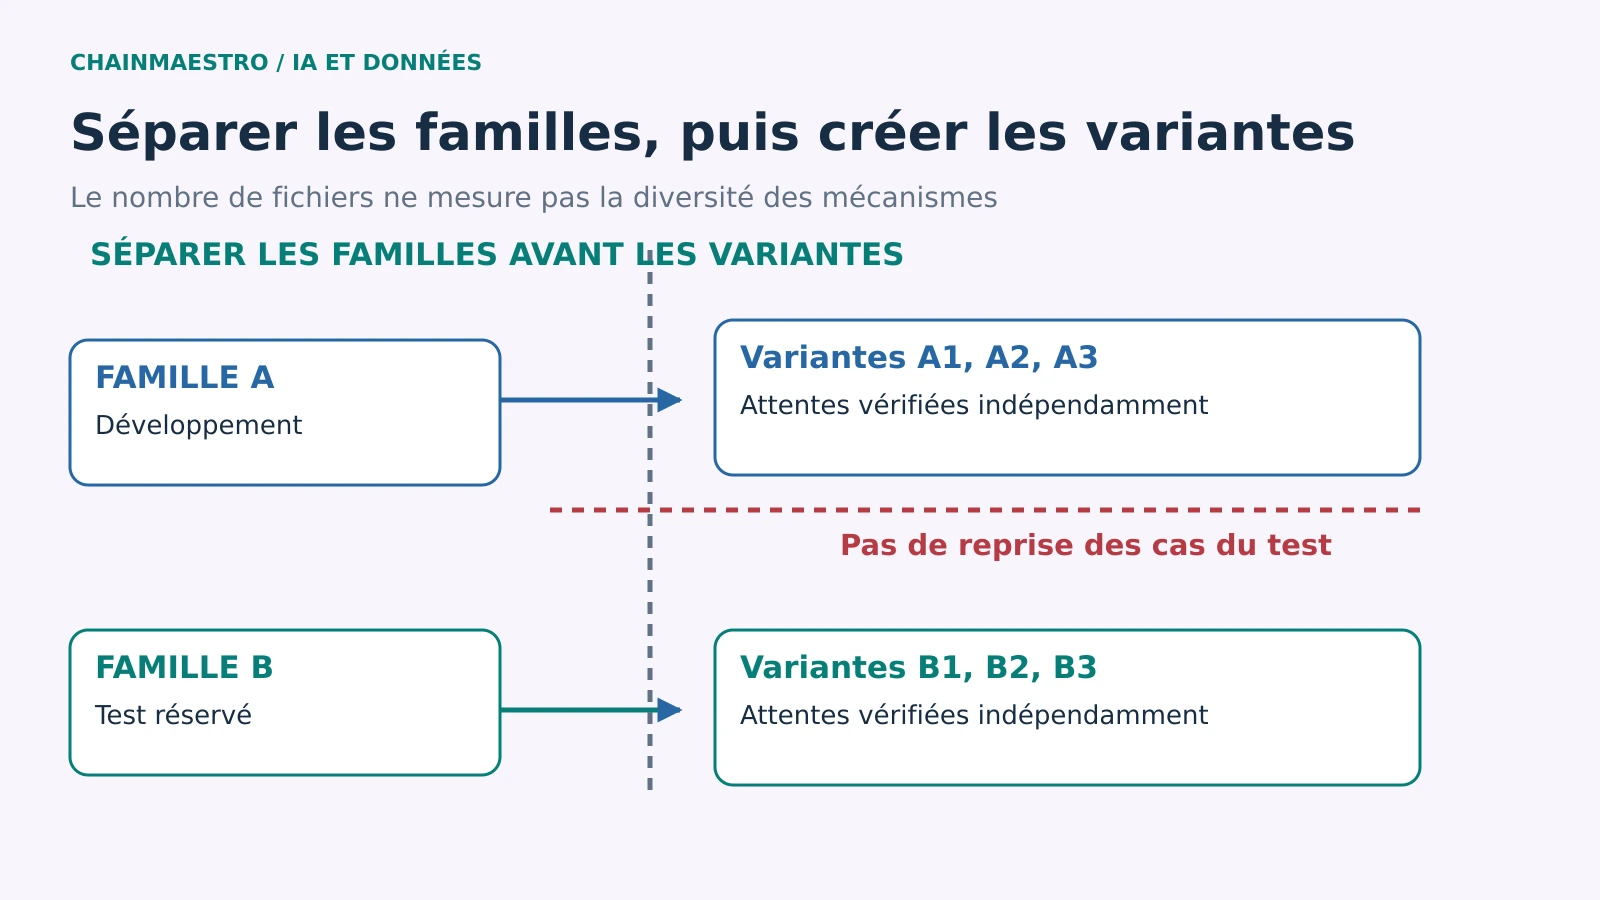
Corpus synthétiques : enrichir les tests sans fabriquer leur réussite
Utiliser des cas générés pour éprouver une IA : provenance, séparation des lots, contamination, diversité et validation indépendante des attentes.
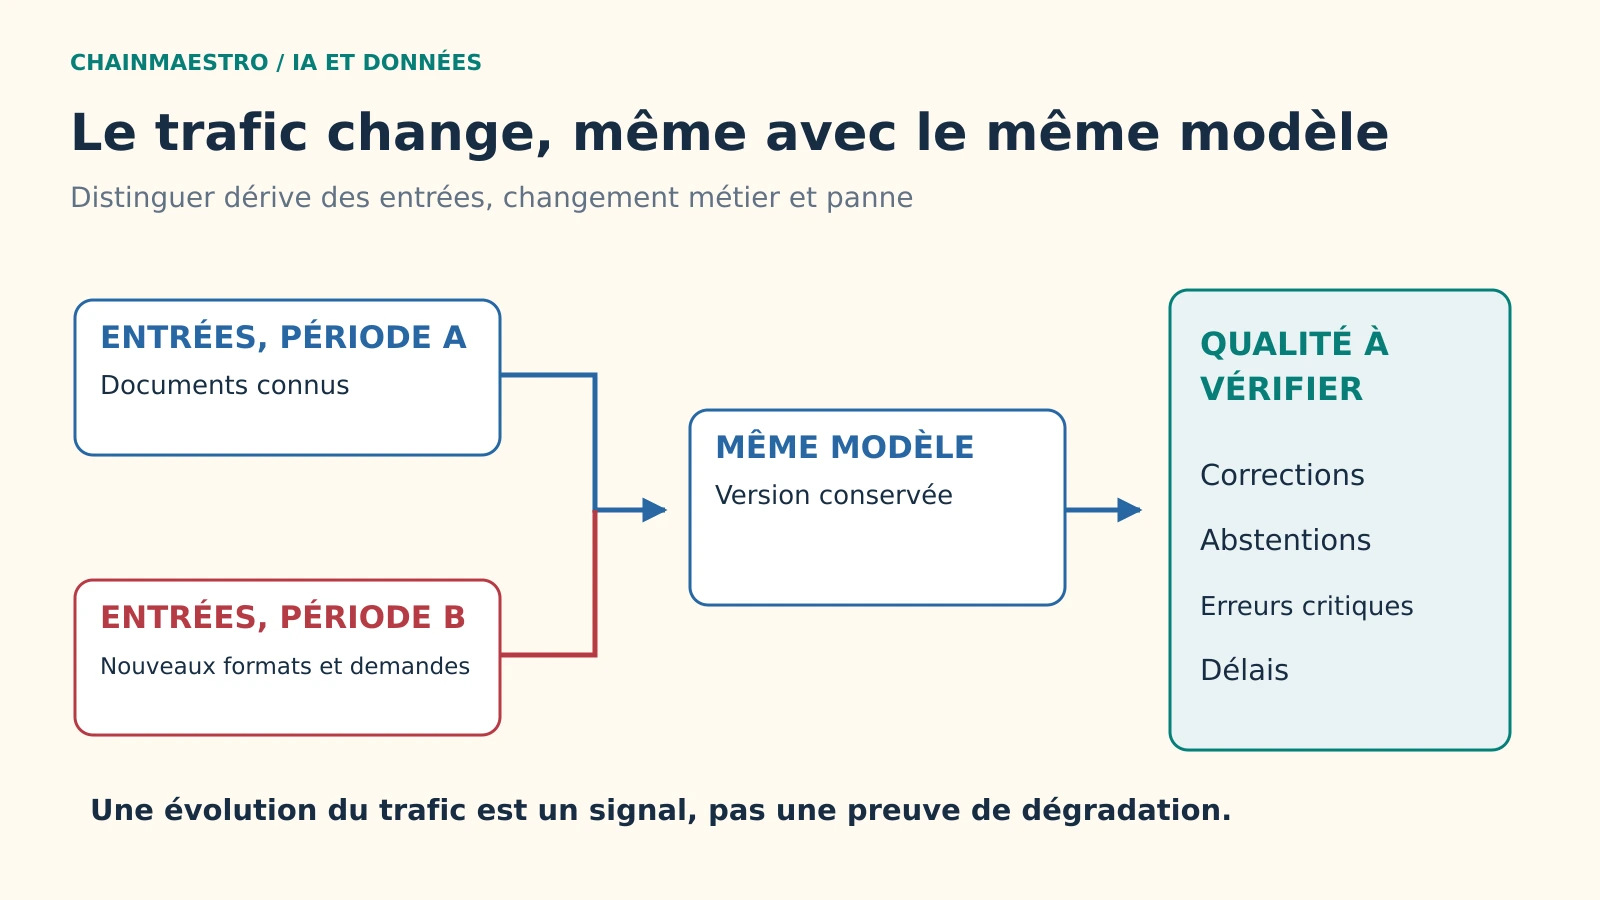
Dérive en production : le modèle peut rester identique et le produit se dégrader
Distinguer changement des entrées, évolution des règles et panne de la chaîne : suivre la qualité réelle d’un système IA après son lancement.
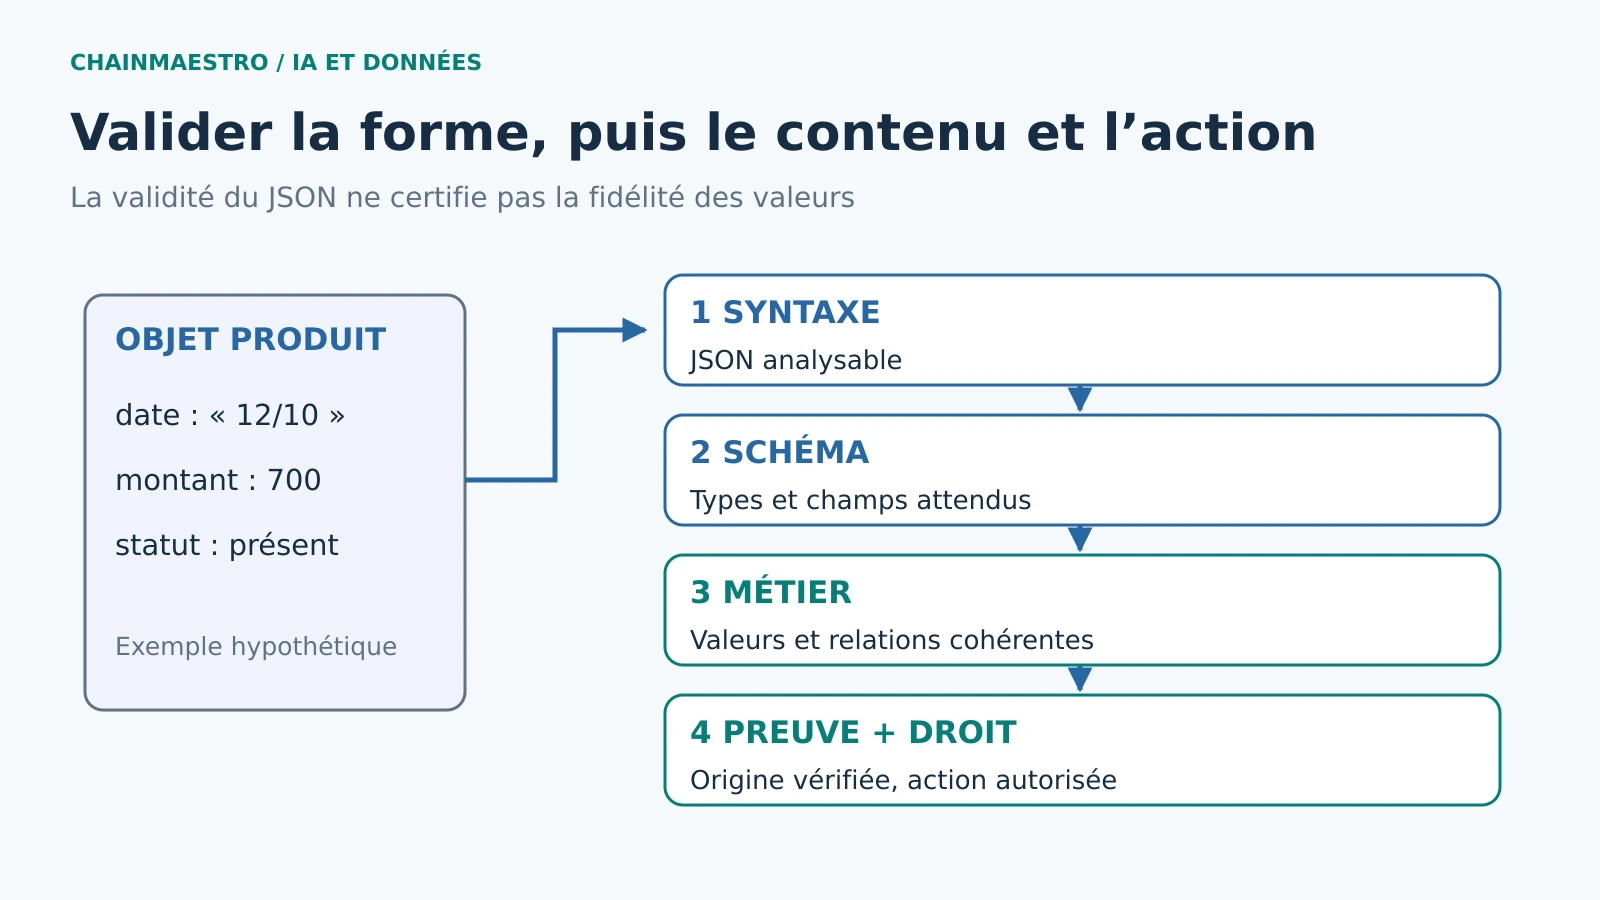
Sorties structurées : un JSON valide peut contenir une réponse fausse
Séparer validation du schéma, cohérence métier et preuve documentaire : concevoir des sorties IA structurées qui gardent leurs incertitudes.
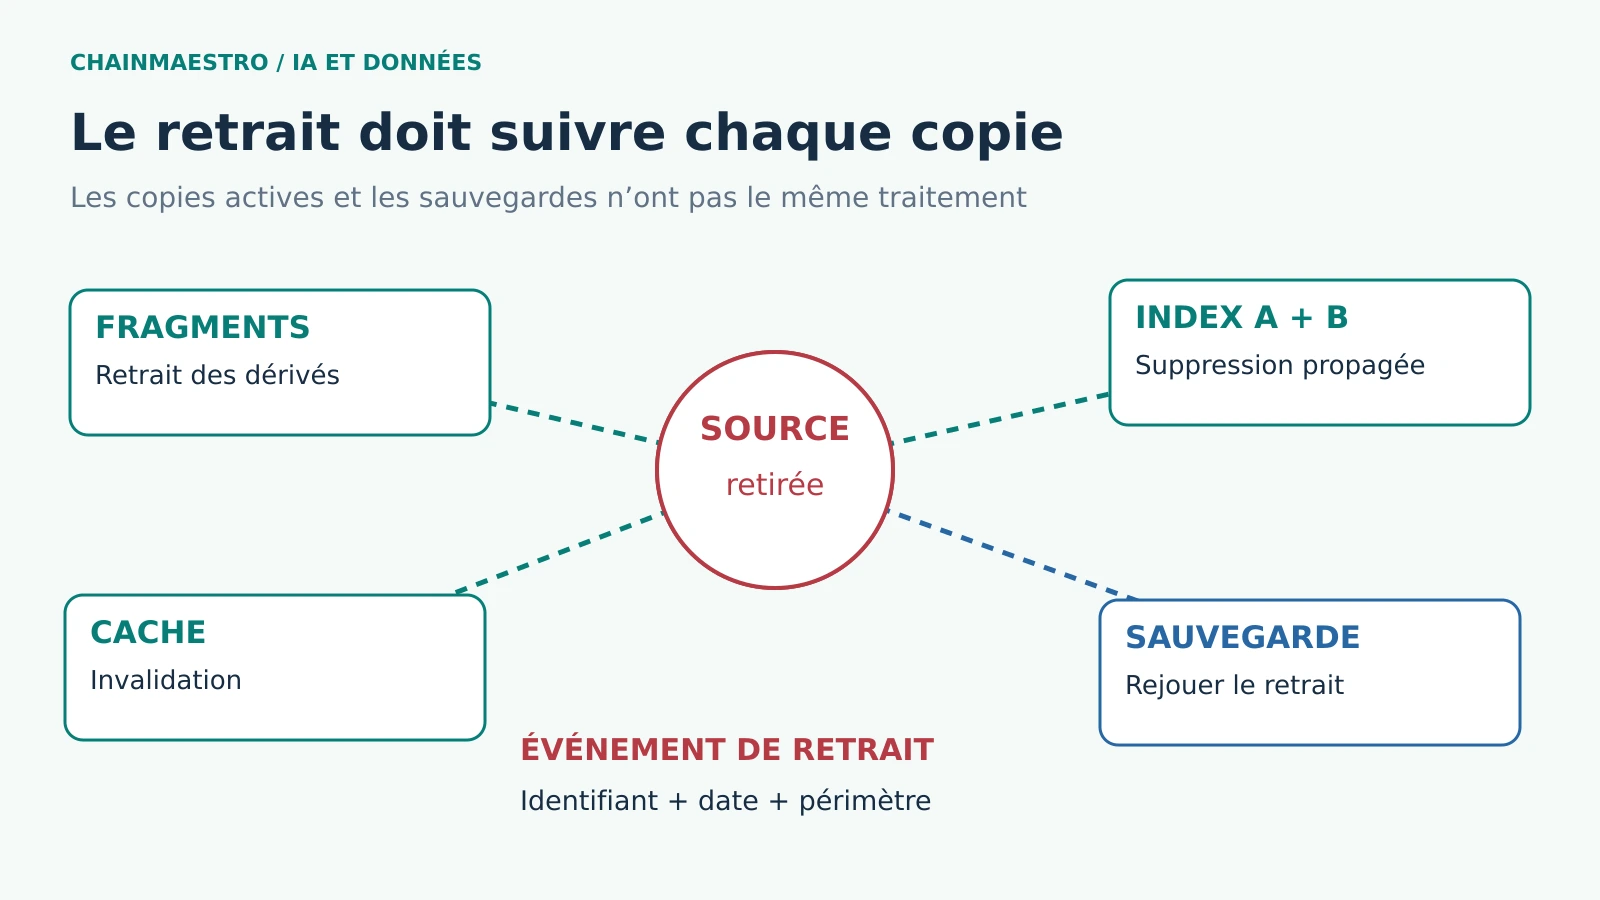
Supprimer une donnée d’un RAG : l’index n’est qu’une des copies
Retirer documents, fragments, vecteurs, caches et sauvegardes : organiser une suppression vérifiable sans réintroduire les données lors d’une restauration.
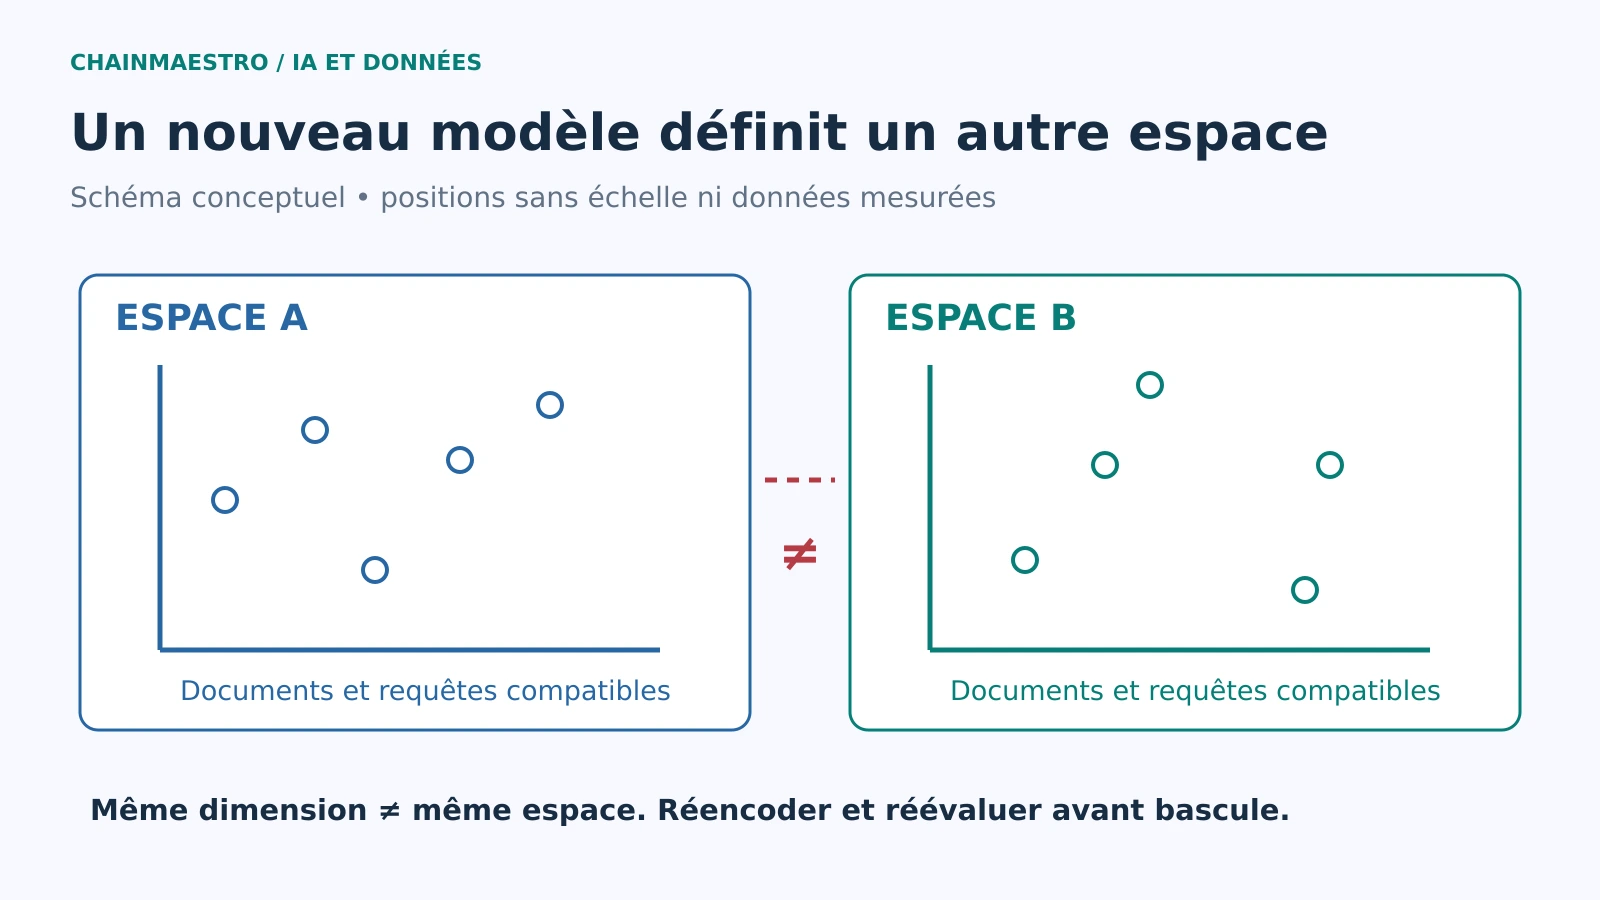
Changer d’embeddings : une migration d’index, pas un simple réglage
Réindexation, compatibilité des vecteurs, seuils et retour en arrière : préparer un changement de modèle d’embeddings sans dégrader la recherche.
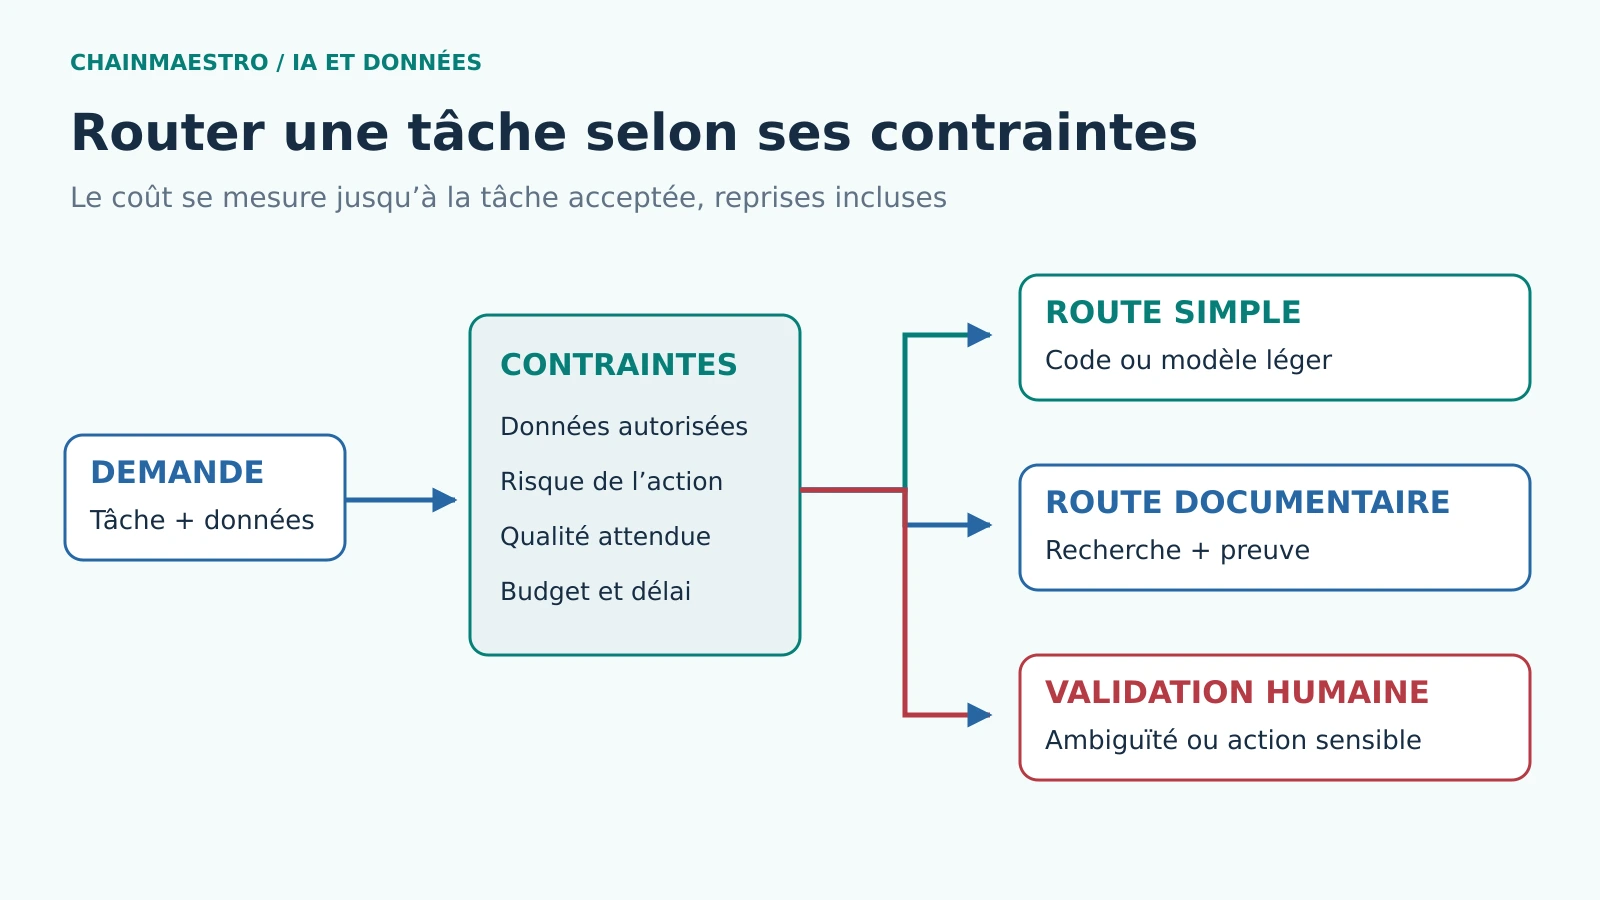
Routage de modèles : économiser par tâche sans déplacer les erreurs
Choisir un modèle selon la difficulté et le risque : mesurer la qualité, les reprises, la latence et le coût réel d’un routeur avant de l’activer.
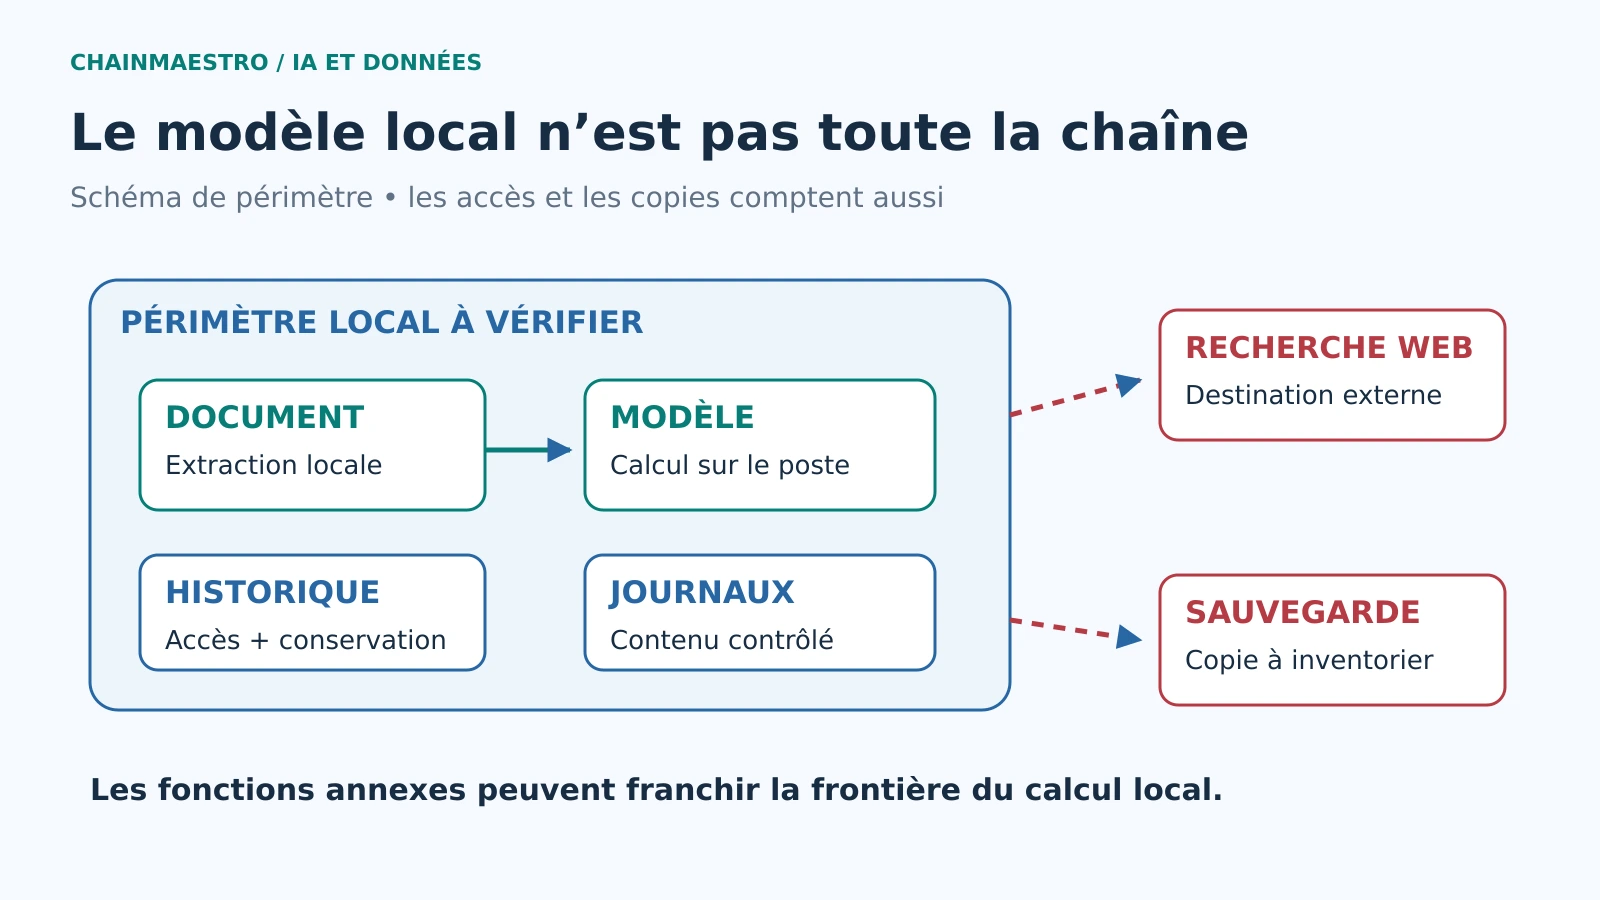
Inférence locale : où s’arrête vraiment la confidentialité ?
Faire tourner un modèle sur un poste ne suffit pas : vérifier les flux réseau, les extensions, les traces et les sauvegardes de toute la chaîne IA.
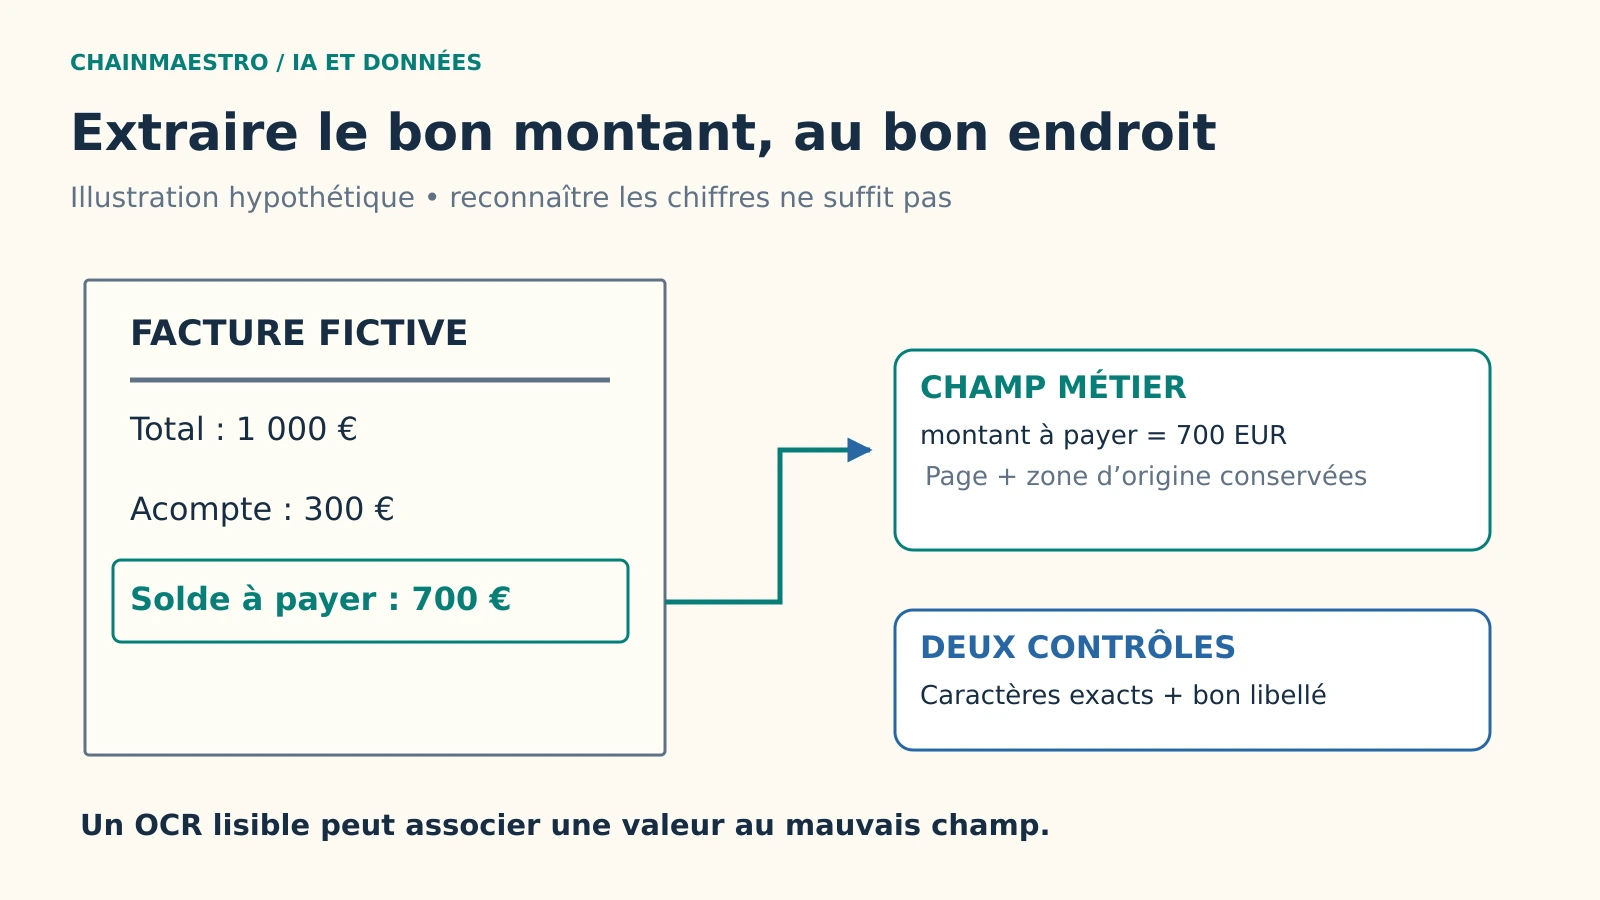
OCR et PDF : mesurer les champs extraits, pas l’apparence du texte
Dates, montants, identifiants : bâtir une recette d’extraction documentaire qui sépare reconnaissance du texte, lecture des tableaux et validation métier.
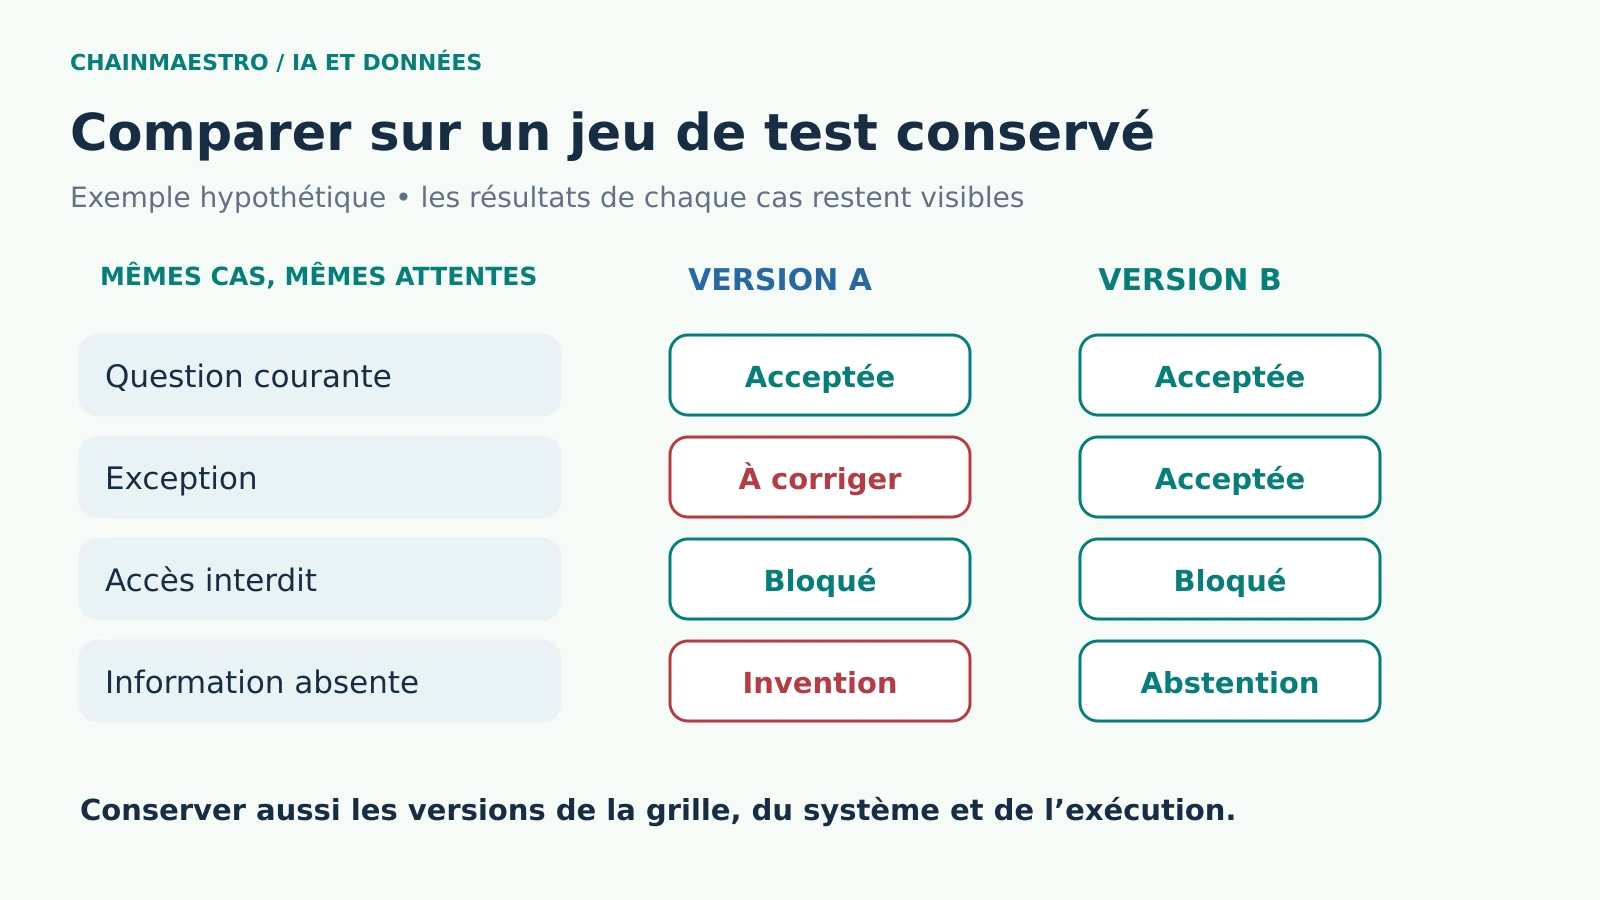
Évaluer une IA : le jeu de test doit devenir un actif versionné
Construire des tests IA comparables : cas représentatifs, annotations, versions, critères d’acceptation et examen des régressions avant mise en production.
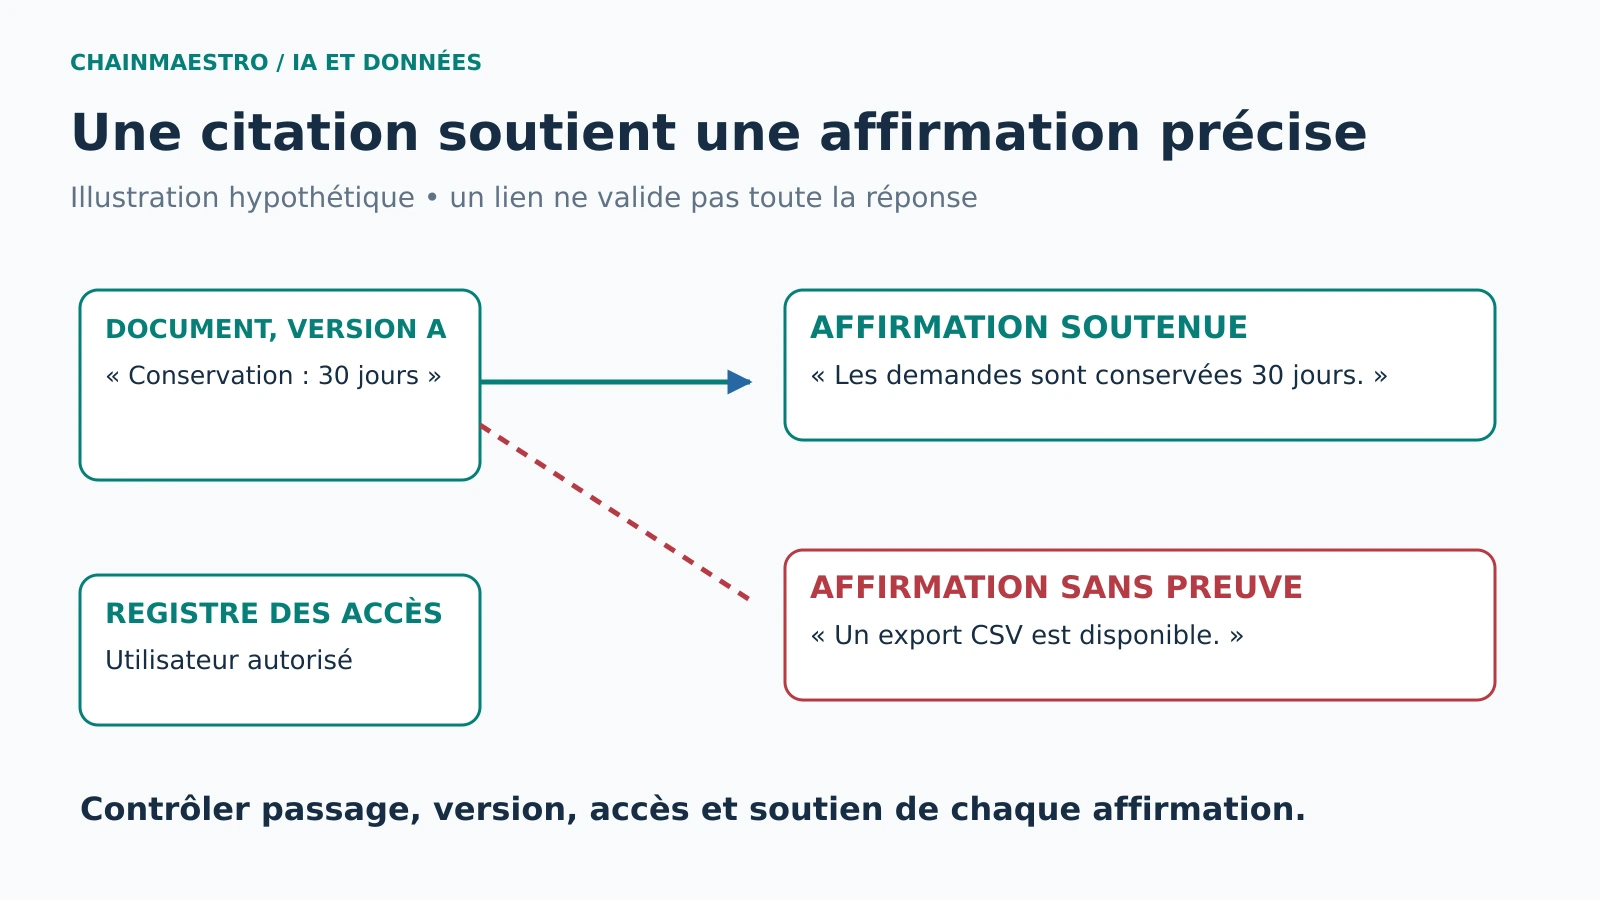
RAG : une citation ne suffit pas à rendre une réponse fiable
Vérifier les passages cités, les droits d’accès et la version des documents : une méthode de recette pour les assistants qui répondent sur vos sources.
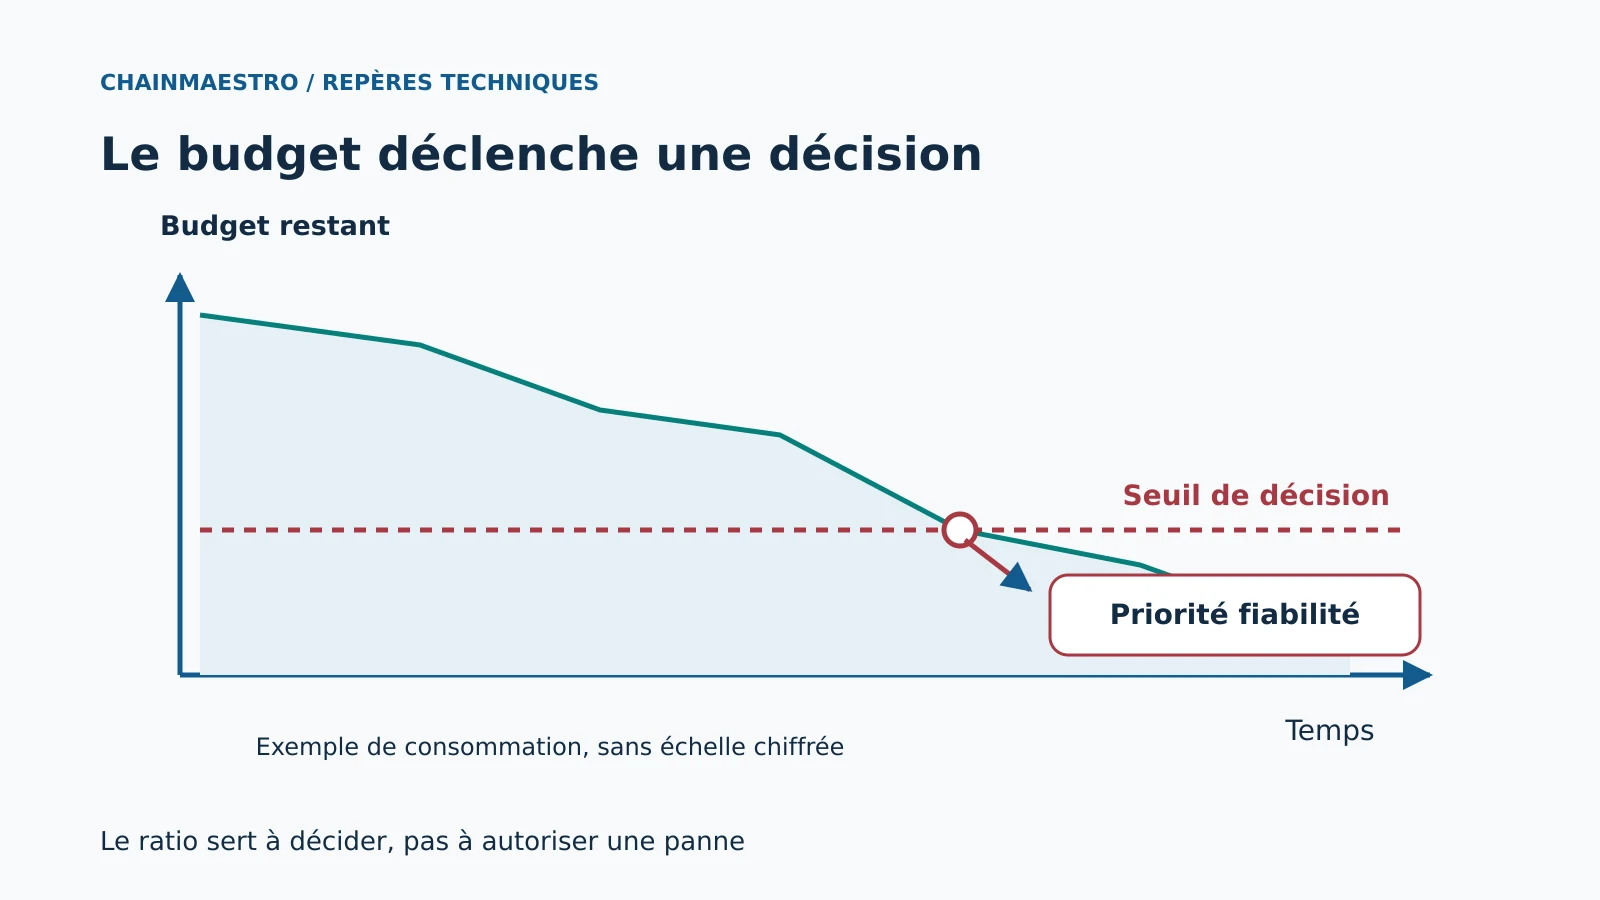
SLO et budget d’erreur : décider quand la fiabilité doit passer devant
Un objectif de service doit conduire à une décision. Définir l’indicateur utilisateur, calculer le budget d’erreur et convenir des actions quand il s’épuise.
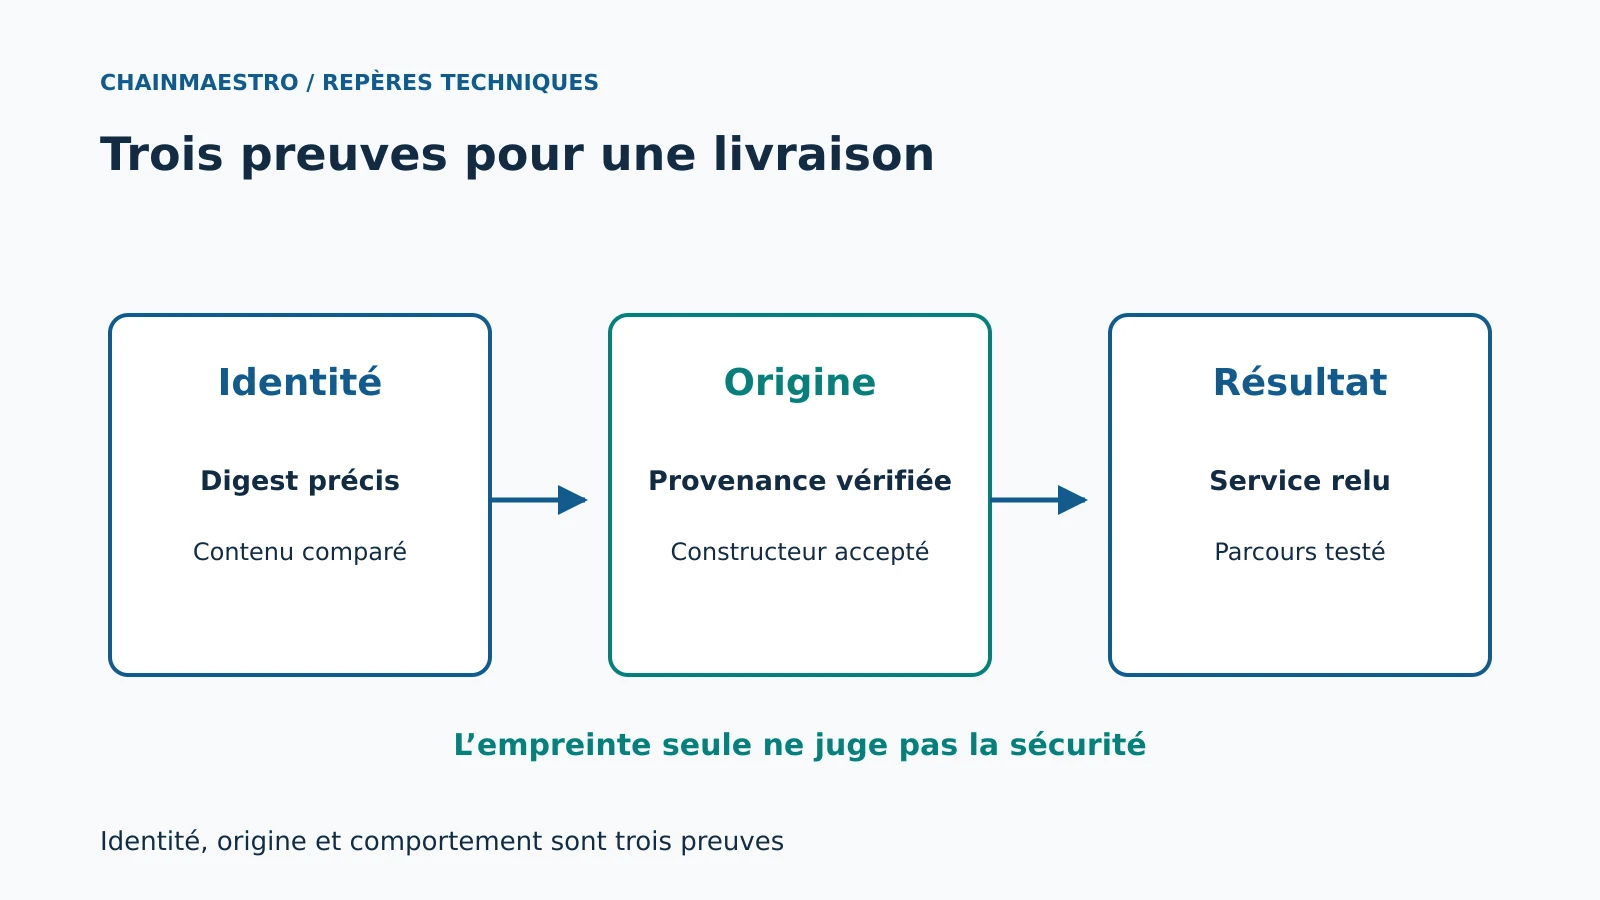
Images conteneurs : le digest identifie, la provenance explique
Épingler une image rend le déploiement identifiable. Vérifier aussi qui l’a construite, à partir de quoi et selon quelle politique de confiance.
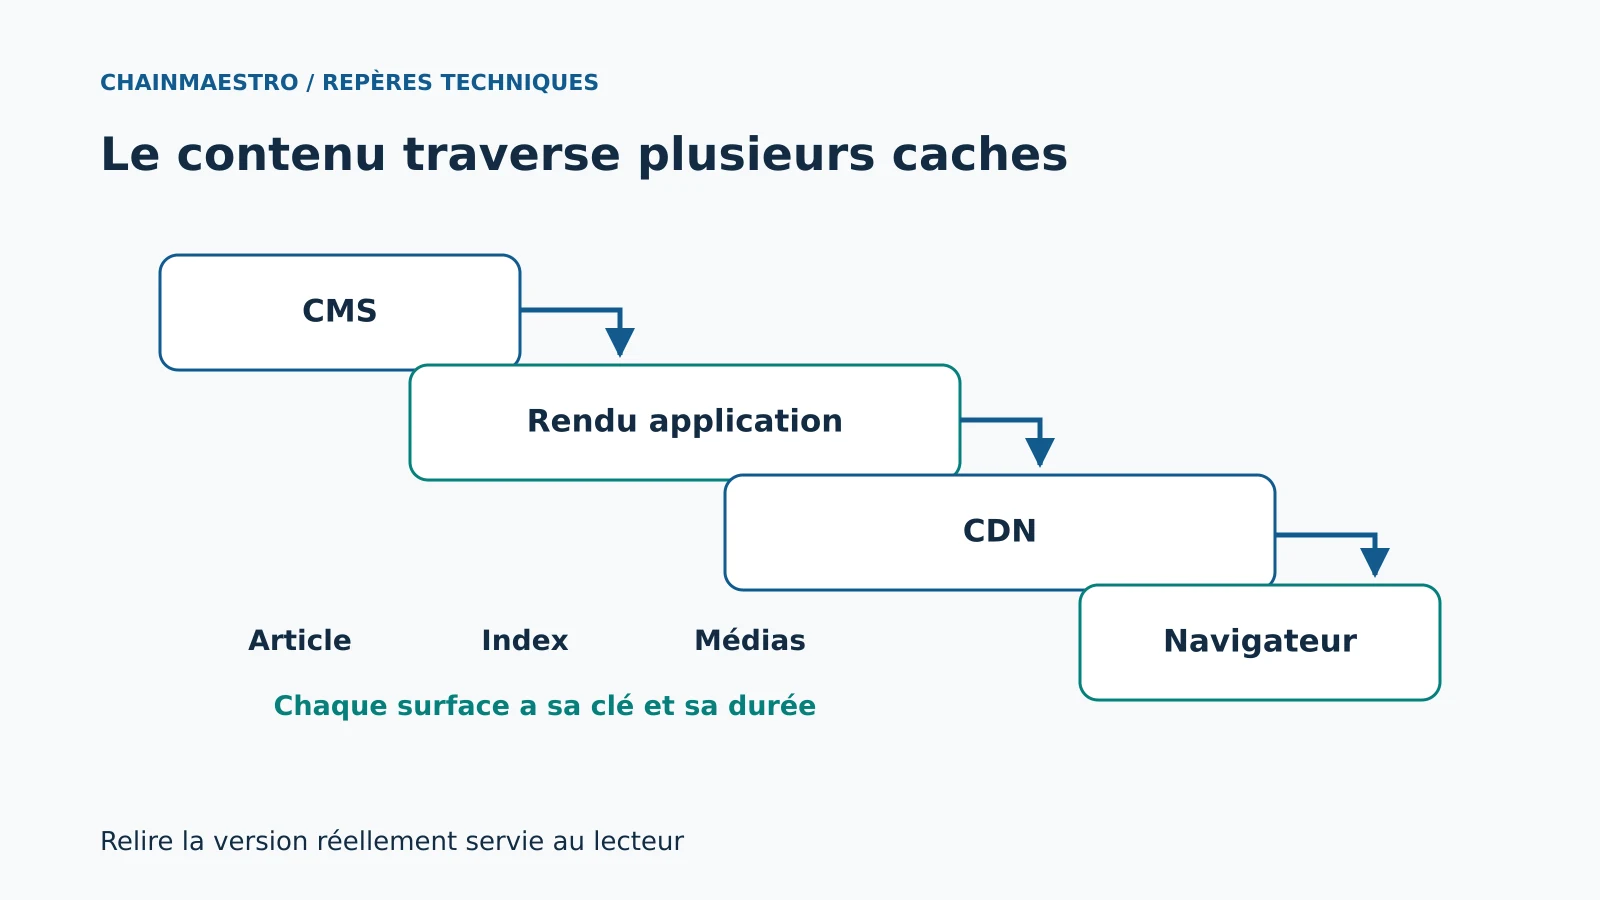
Cache CDN : une publication n’est terminée qu’une fois visible
Le CMS peut être à jour pendant que les lecteurs voient l’ancienne page. Cartographier les caches, cibler les invalidations et vérifier le rendu public.
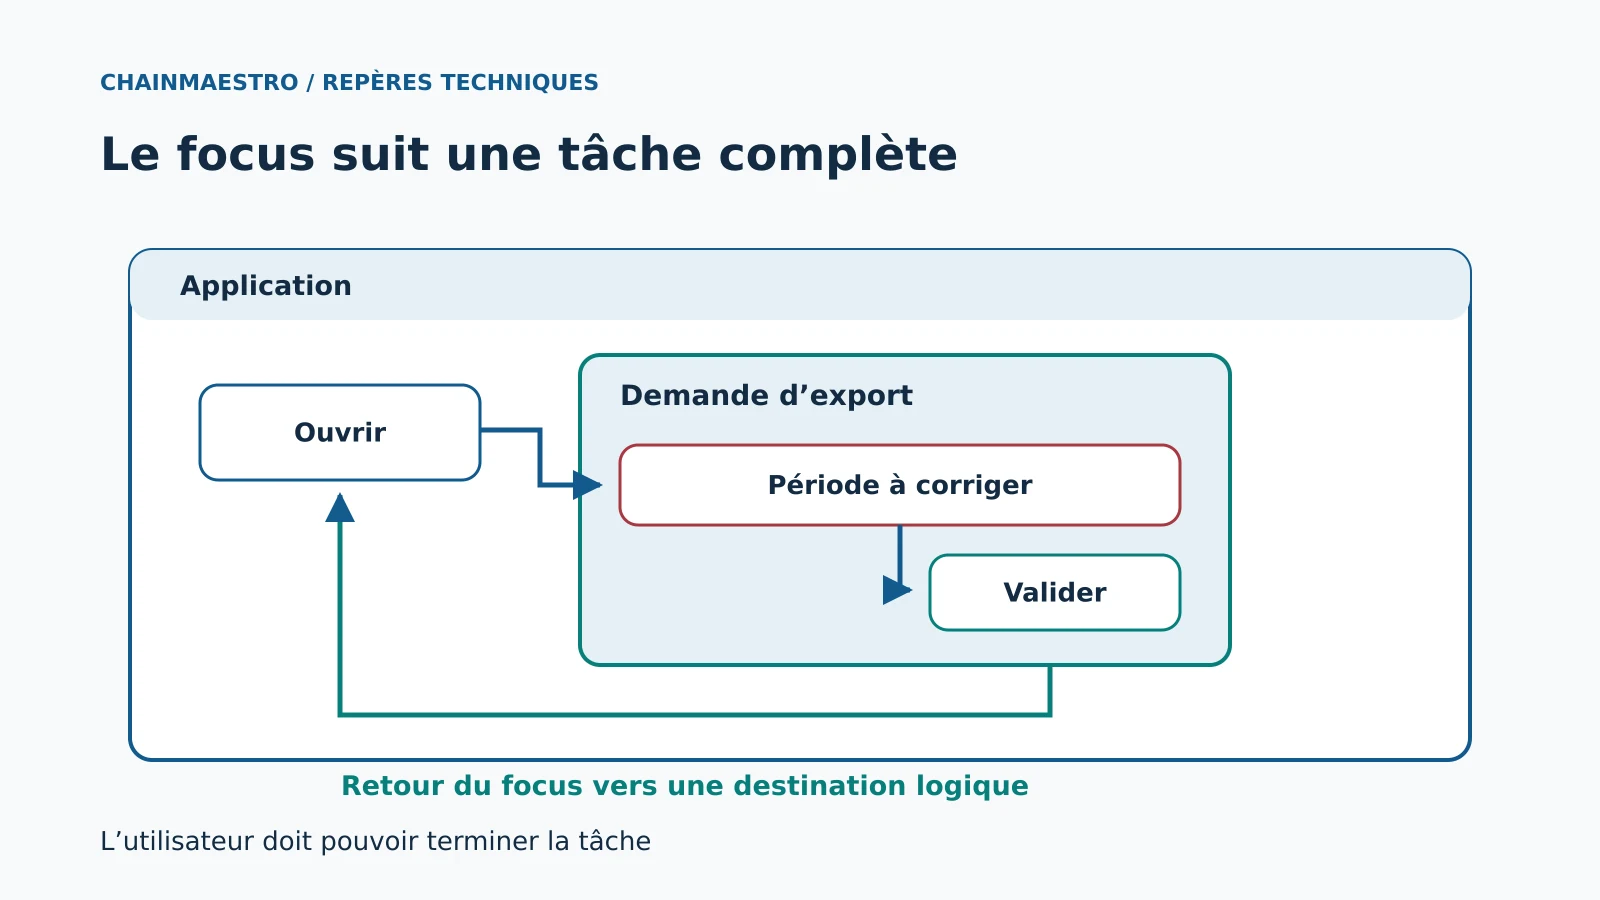
Accessibilité clavier : tester le parcours, pas seulement les boutons
Un contrôle focusable ne garantit pas un parcours utilisable. Vérifier ordre, visibilité, modales et retour du focus dans les tâches réelles.
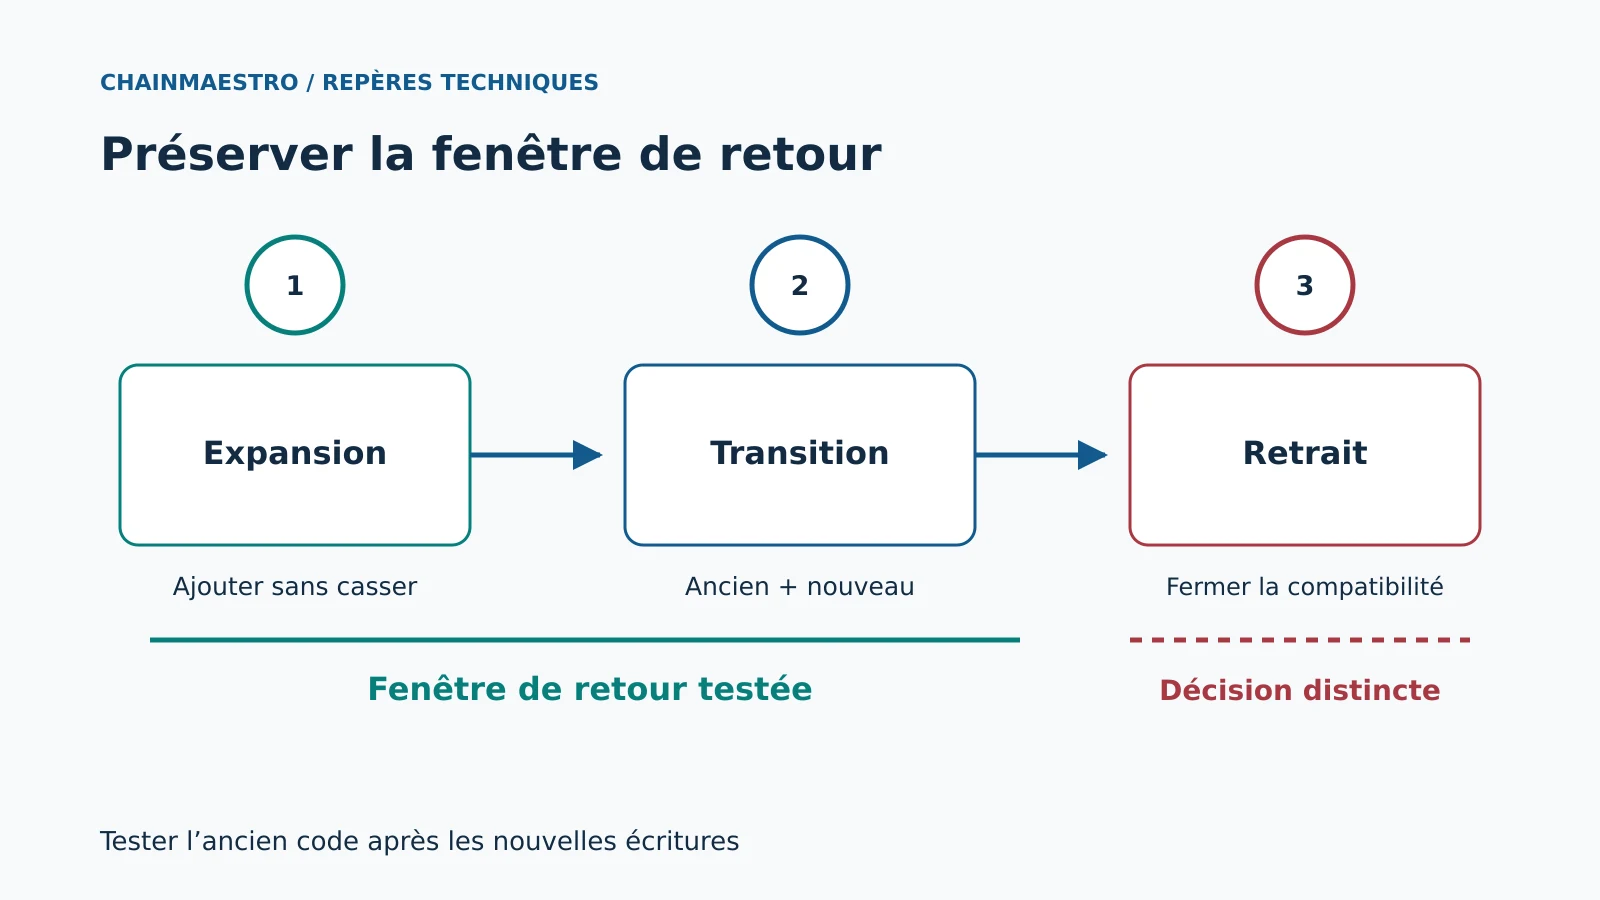
Migrations de base : tester le retour de l’application avant de déployer
Revenir à l’ancienne application exige un schéma compatible. Concevoir expansion, transition et retrait, puis éprouver les écritures pendant la migration.
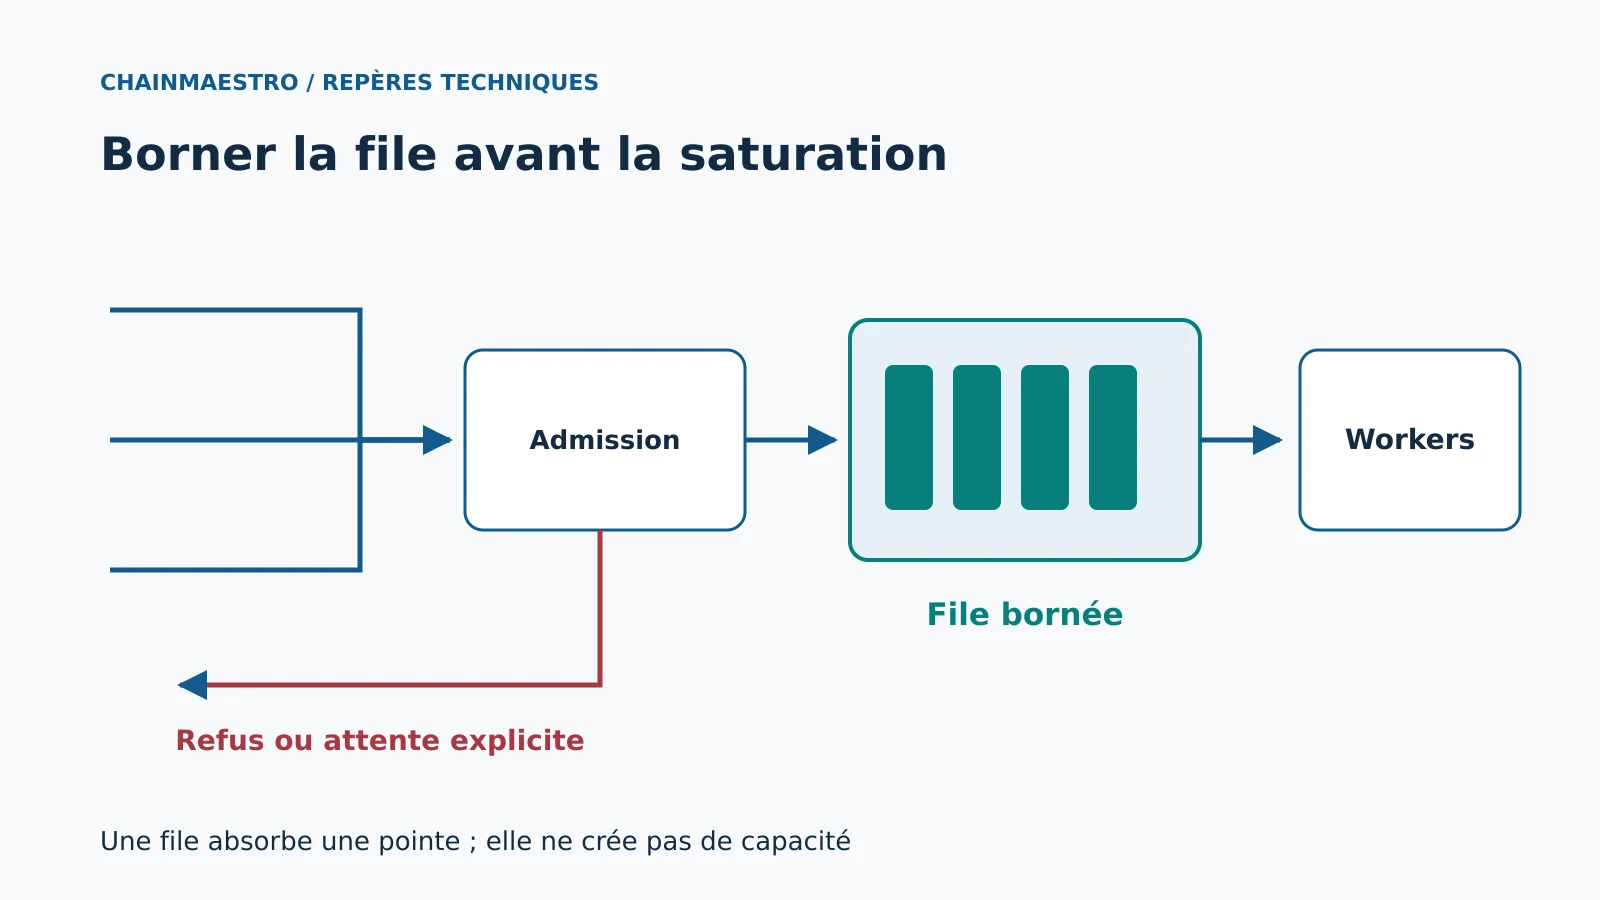
API sous charge : fixer les limites avant que la file déborde
Limiter le débit ne suffit pas à absorber une surcharge. Borner les files, maîtriser les reprises et préserver les opérations essentielles.
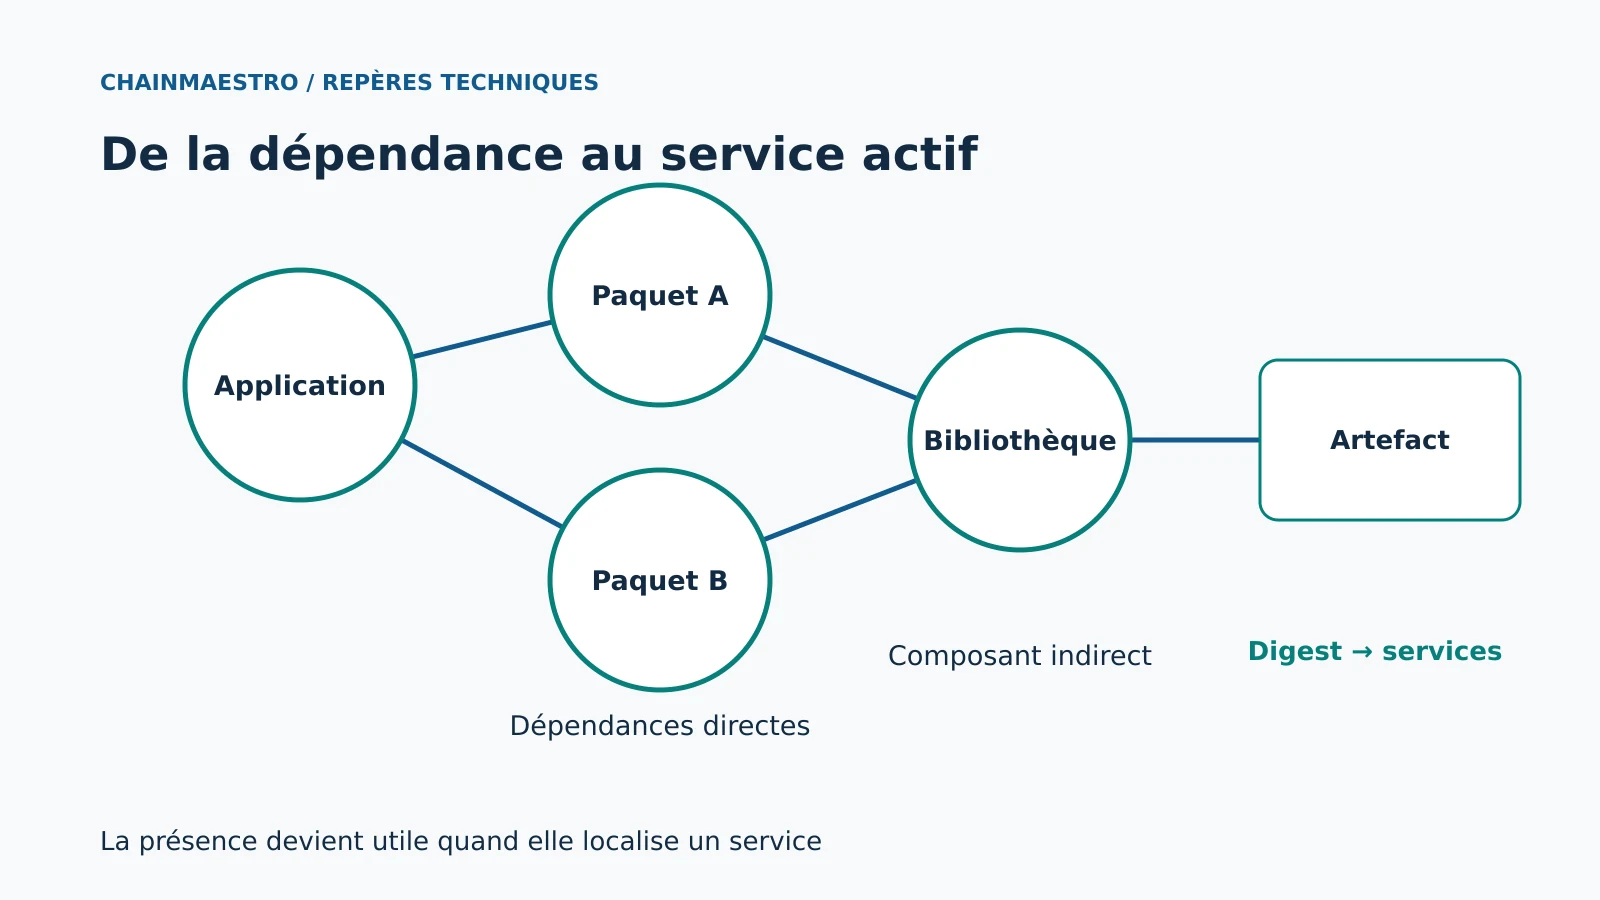
SBOM : transformer la liste des dépendances en inventaire exploitable
Une SBOM aide à retrouver un composant touché. Relier inventaire, artefact et déploiement pour décider vite sans confondre présence et exposition.
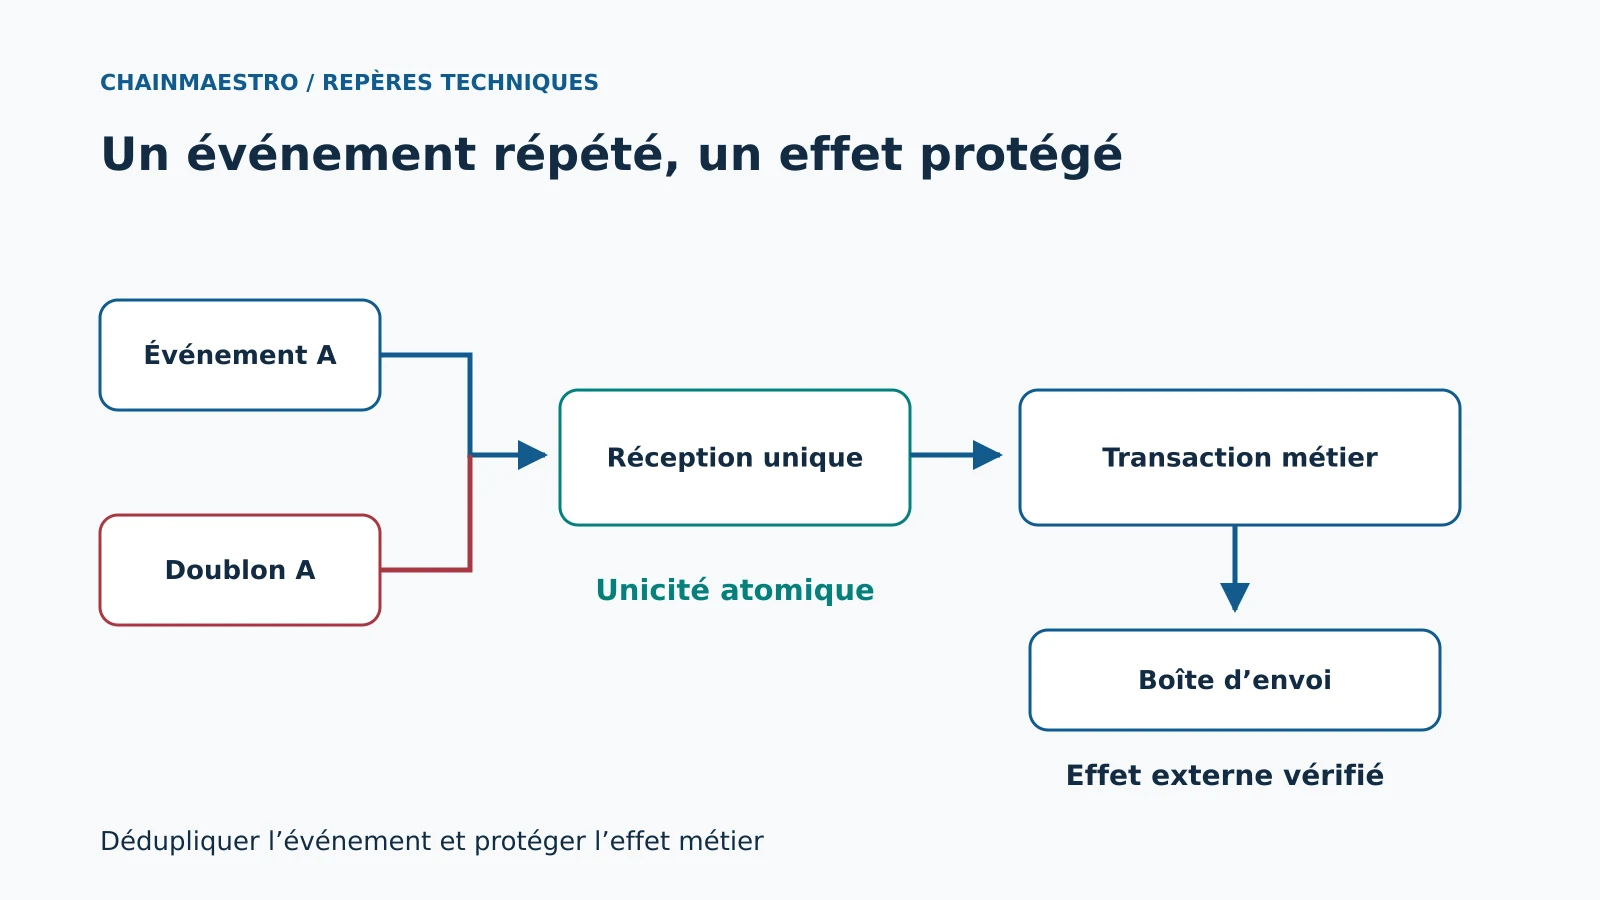
Webhooks : traiter les doublons sans répéter l’action métier
Un webhook peut arriver deux fois ou dans le désordre. Dédupliquer, traiter durablement et réconcilier les effets pour éviter les doubles actions.
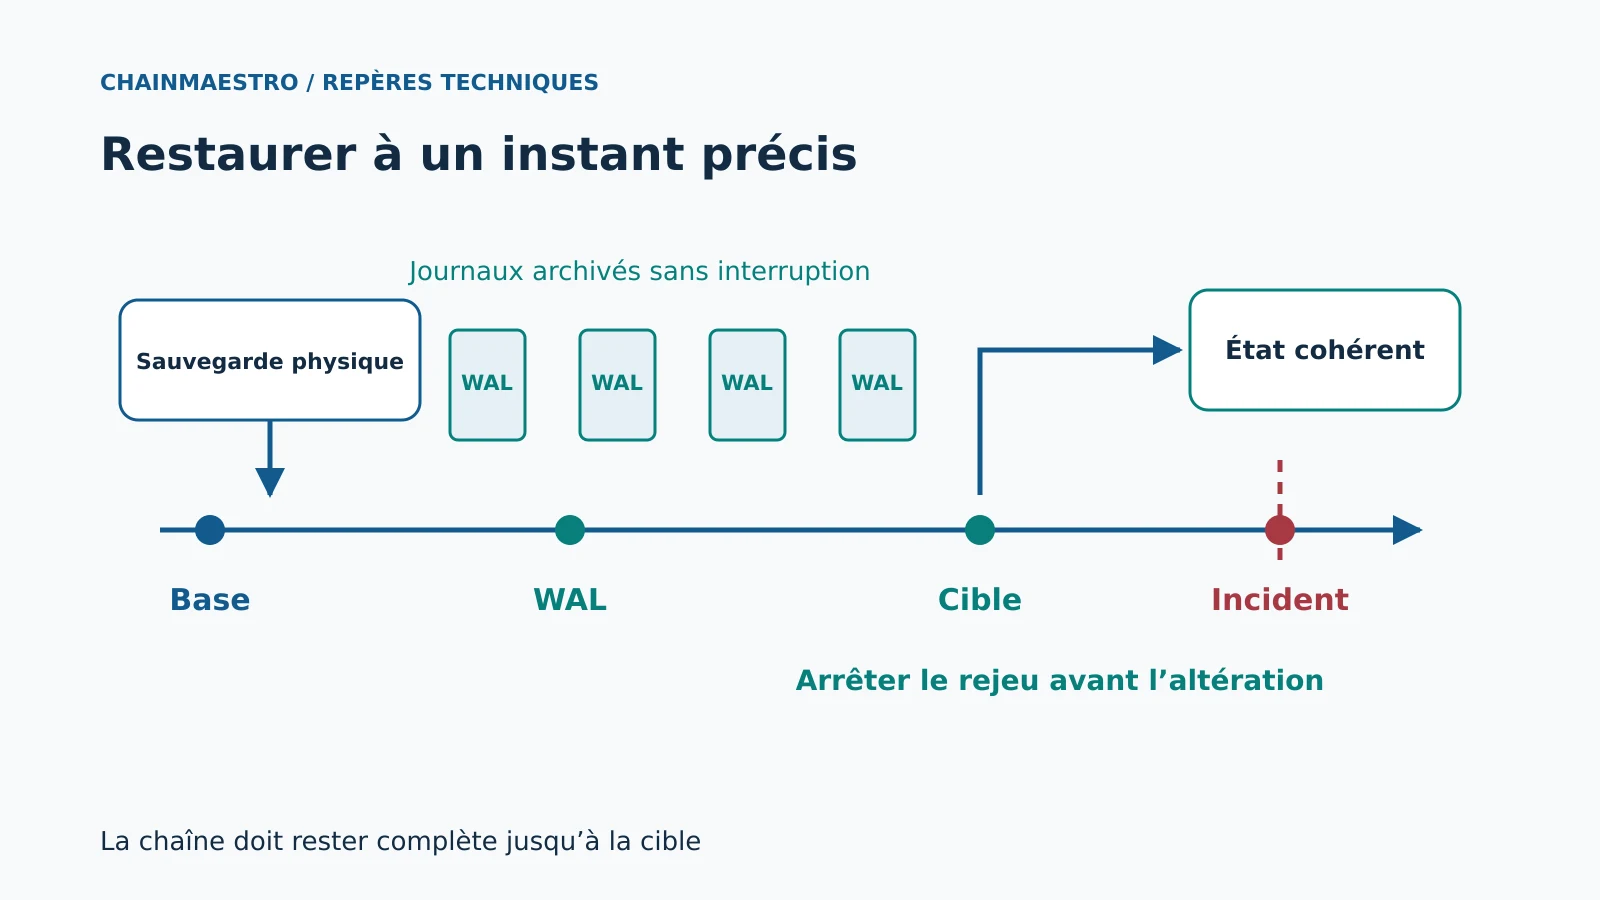
Sauvegardes PostgreSQL : la restauration est le véritable test
Une sauvegarde réussie ne prouve pas que le service peut repartir. Choisir les bons objectifs, tester le rejeu et mesurer la reprise PostgreSQL.

Conversion Rate Optimization : 15 techniques qui fonctionnent vraiment
La CRO ne se résume pas aux boutons. Voici une méthode complète pour diagnostiquer, tester et améliorer les conversions sans sacrifier la qualité.

Tunnel de Vente Optimisé : Guide Complet 2025
Un tunnel de vente optimisé ne force pas les prospects : il clarifie les étapes, les preuves, les critères de passage et les frictions qui empêchent les bons acheteurs d'avancer.