Ce qu’il faut retenir
- Des cas synthétiques aident à explorer des variations et des erreurs rares, mais ils ne représentent pas automatiquement le trafic réel.
- Générer questions et réponses avec le même système peut produire un test favorable à ses habitudes et à ses défauts.
- Provenance, séparation des familles et validation des réponses attendues doivent être conservées avec chaque lot.
Sources de recherche consultées le 1er octobre 2026. Les résultats des publications citées restent liés à leurs protocoles.
Il manque des exemples pour tester un assistant. Un modèle peut en produire rapidement : demandes de support, pièces factices, variantes linguistiques et réponses attendues. La commodité est réelle. Le piège consiste à croire que la quantité générée suffit à rendre l’évaluation robuste. Un lot cohérent peut surtout refléter ce que le générateur sait écrire et ce qu’il suppose être la bonne réponse.
Donner un rôle précis au synthétique
Un cas synthétique est construit plutôt que directement prélevé dans l’usage. Il peut venir d’une règle déterministe, d’un modèle génératif ou d’une combinaison. Une facture factice calculée à partir de règles possède des montants vérifiables. Une question rédigée par un modèle peut être plausible sans correspondre à une demande fréquente. Ces objets ne doivent pas recevoir la même valeur de preuve.
Trois rôles sont utiles : enrichir le développement, tester des limites et compléter une évaluation. Les résultats doivent rester séparés selon le rôle et l’origine. Le synthétique peut exposer une faiblesse ; il ne permet pas à lui seul d’estimer le taux d’erreur sur le trafic réel. Une distribution générée n’est pas automatiquement celle des clients.
Le dossier sur les outils IA utilisés par les équipes rappelle la diversité des tâches. Un lot synthétique doit donc partir d’une tâche et d’un défaut à examiner : ambiguïté, format inattendu, contradiction ou accès interdit. « Génère beaucoup de questions variées » ne définit pas une recette.
La contamination dépasse la copie exacte
Une évaluation est contaminée lorsque des informations du test ont contribué à préparer le système, de façon à gonfler son résultat sans démontrer la généralisation attendue. Cela peut concerner l’entraînement, les exemples du prompt, le réglage des consignes ou l’accès à une réponse de référence pendant l’essai. La frontière doit être décrite pour savoir ce que la mesure établit.
La publication Rethinking Benchmark and Contamination for Language Models with Rephrased Samples montre, dans ses expériences, que paraphrases et traductions peuvent échapper aux détections fondées sur le simple recouvrement textuel. Elle signale également des risques dans des ensembles synthétiques. Ce constat invite à séparer les familles de cas, sans prétendre qu’une méthode unique détecte toutes les contaminations.
Le texte de recherche NLP Evaluation in trouble souligne l’incertitude entourant l’exposition des modèles aux benchmarks et la nécessité de la documenter. Pour une équipe produit, la conséquence est de publier les limites de son test : origine connue des cas, informations visibles pendant l’exécution et éléments qui restent inconnus sur le modèle.
Séparer les familles avant de produire les variantes
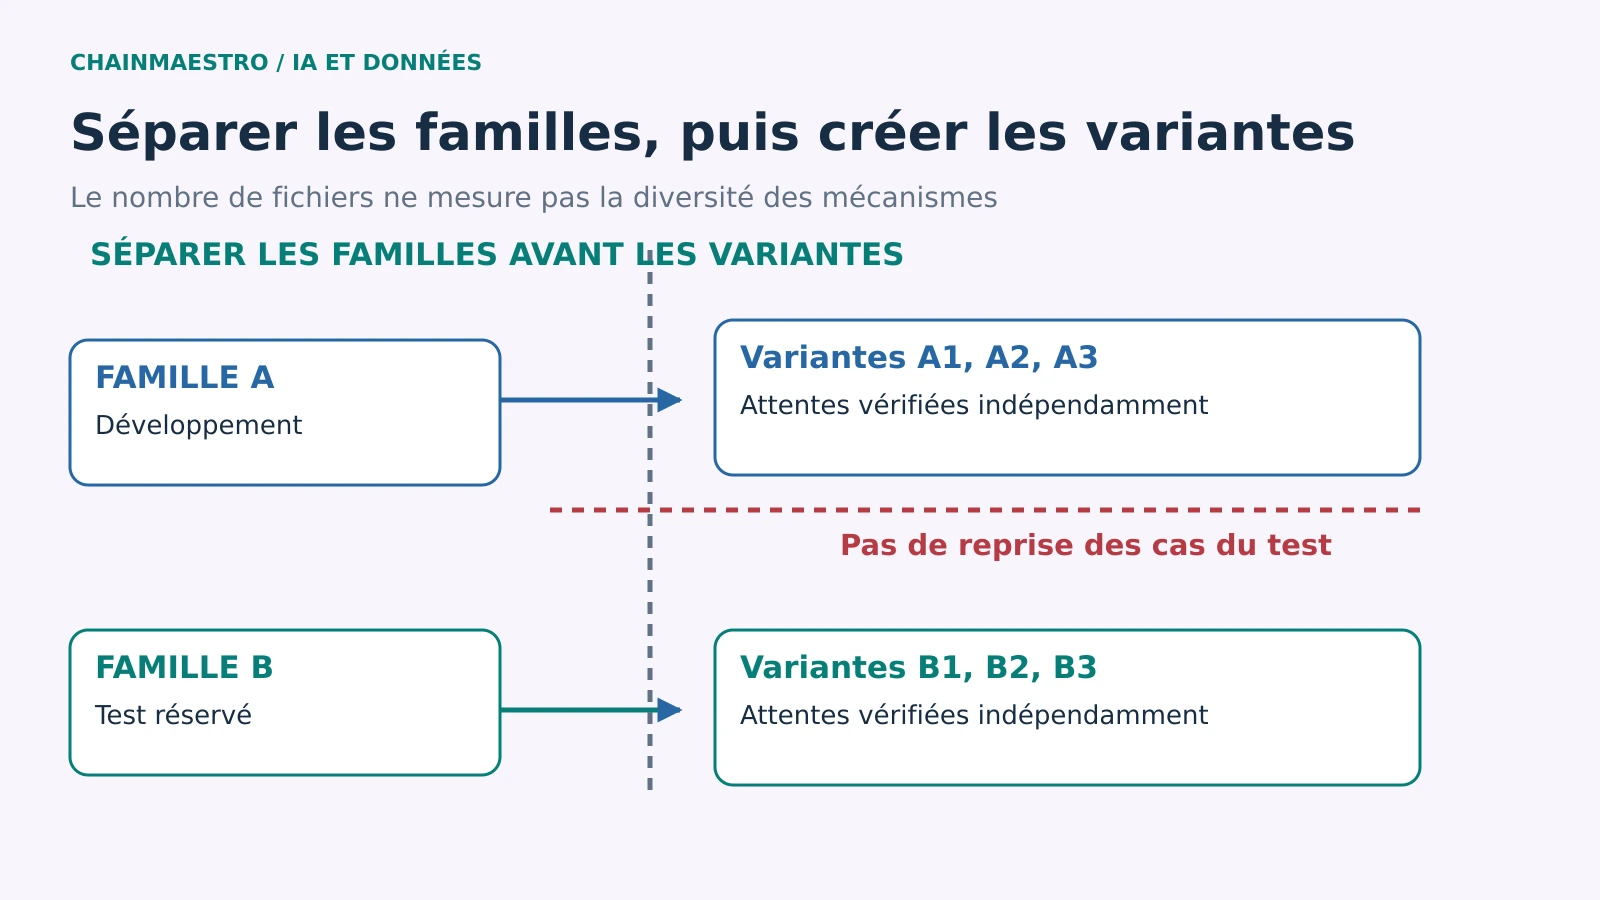
Si une question est paraphrasée vingt fois puis répartie au hasard entre développement et test, les lots restent proches. Séparer d’abord scénarios, documents sources, gabarits ou familles de clients ; générer ensuite les variantes à l’intérieur de chaque lot. Une référence changeante doit être remplacée par plusieurs scénarios indépendants, pas seulement par des reformulations de surface.
| Lot | Usage | Information conservée |
|---|---|---|
| Développement | Comprendre les défauts et ajuster | Origine, générateur, consigne et corrections |
| Validation | Choisir une configuration | Familles distinctes, attentes vérifiées |
| Test réservé | Décider une sortie | Accès limité et historique des consultations |
| Trafic réel annoté | Estimer l’usage observé | Échantillonnage, période et limites |
La documentation scikit-learn sur les fuites de données fournit le principe de séparation. Pour une application générative, il faut l’appliquer au développement du système complet. Un test consulté à chaque retouche ne reste pas réservé simplement parce qu’il porte ce nom dans un fichier.
Vérifier la réponse attendue indépendamment
Un générateur peut produire une question et une réponse qui partagent une erreur. Faire évaluer la réponse par le même modèle peut renforcer cette erreur. La référence devrait venir d’une règle vérifiable, d’une pièce de preuve ou d’une annotation compétente. Un second modèle peut aider au tri, mais sa présence ne fournit pas automatiquement l’indépendance ni la vérité.
Pour une extraction, construire des documents à partir de champs connus permet de garder une référence déterministe. L’image finale doit être vérifiée : un rendu, une troncature ou un tableau modifié peut changer la donnée effectivement visible. Pour une question documentaire, la référence renvoie au passage qui soutient la réponse. Pour un agent, elle inclut l’action autorisée et les actions interdites.
Les ambiguïtés doivent rester représentables. Si deux lecteurs compétents ne peuvent pas trancher, ce cas peut tester la clarification plutôt qu’une réponse unique forcée. Le lot gagne ainsi une valeur opérationnelle : il apprend à la recette où une abstention ou une demande d’information est appropriée.
Des factures synthétiques pour tester une extraction
Scénario hypothétique. Une PME prépare un extracteur de factures et manque d’exemples d’avoirs. Elle crée des pièces factices avec fournisseurs inventés, totaux calculés et statuts attendus. Elle varie disposition, libellés et qualité d’image. Les familles de gabarits réservées au test ne servent pas à ajuster les prompts.
Les montants de référence proviennent du calcul qui a produit chaque facture. La pièce rendue est relue pour vérifier que les champs sont visibles et associés au bon libellé. Un modèle peut aider à reformuler des mentions, mais la comptabilité valide qu’elles décrivent bien le statut attendu. Un lot réel anonymisé, tenu séparément, permet d’observer les différences avec les documents reçus.
La mesure distingue fidélité sur synthétique, fidélité sur réel et erreurs par champ. Une amélioration limitée aux gabarits factices n’autorise pas le déploiement général. Elle peut toutefois justifier un correctif ciblé, ensuite testé sur les deux lots. Les cas impossibles, comme une somme incompatible avec les lignes, servent à tester le signalement d’incohérence plutôt qu’à être effacés du lot.
Compter les mécanismes, pas seulement les fichiers
Mille variantes d’un même patron ne représentent pas mille difficultés indépendantes. Suivre nombre de familles, propriétés variées et combinaisons testées donne une meilleure lecture de la couverture. L’équipe peut tenir une matrice : format, langue, bruit, absence de champ, contradiction, droit d’accès et type de tâche.
Certaines combinaisons sont inutiles ou irréalistes. D’autres correspondent à un risque rare qui mérite un test sans être pondéré comme le trafic courant. Les résultats doivent garder ces catégories. Une moyenne qui mélange tests d’attaque extrêmes et demandes ordinaires ne décrit clairement ni la robustesse ni la qualité quotidienne.
Les risques de sécurité des agents fournissent des mécanismes à tester : document malveillant, mauvaise ressource, destination interdite. Les outils disponibles via MCP déterminent quels effets sont possibles. Les données de test peuvent être fictives tout en reproduisant précisément une frontière d’autorisation.
Conserver la provenance et les corrections
- Écrire l’objectif du lot. Tâche, risque, familles et statut dans l’évaluation.
- Enregistrer la génération. Outil, version disponible, consigne, paramètres et date.
- Vérifier les attentes. Source indépendante, règle ou annotation, avec arbitrages documentés.
- Détecter les proximités. Comparer textes et familles entre lots ; examiner les variantes qui échappent à la correspondance exacte.
- Séparer les résultats. Réel, synthétique et tests de limites gardent leurs effectifs et leurs métriques.
- Renouveler le test réservé. Un lot trop souvent consulté peut rester utile comme régression, mais perd son rôle de mesure indépendante.
La validation des cas fait partie du coût complet de l’IA. Produire un fichier vite n’est pas la même chose que produire une référence fiable. Mesurer le temps de revue, les rejets et les corrections évite d’attribuer au synthétique une économie qui disparaît lors de l’annotation.
Une preuve locale, avec des inconnues
L’équipe ne connaît pas toujours les données d’entraînement d’un modèle hébergé. Elle ne peut alors certifier l’absence de toute contamination. Elle peut en revanche décrire ses propres séparations, utiliser des cas réservés et confronter les résultats à l’usage réel. Une réserve explicite est plus utile qu’une affirmation absolue impossible à vérifier.
Le premier lot synthétique devrait viser une faiblesse précise et fournir une référence relisible. Le compléter par des cas réels et par une revue indépendante permet de juger ce qu’il apporte. Sa valeur vient de la difficulté qu’il rend observable, pas de la quantité de texte qu’il produit.
Sources et références
Sources primaires consultées le 1er octobre 2026 : Yang et collaborateurs, contamination et reformulations, 2023 ; Sainz et collaborateurs, NLP Evaluation in trouble, 2023 ; scikit-learn, fuites et séparation. Les procédures et les factures décrites sont hypothétiques.