Ce qu’il faut retenir
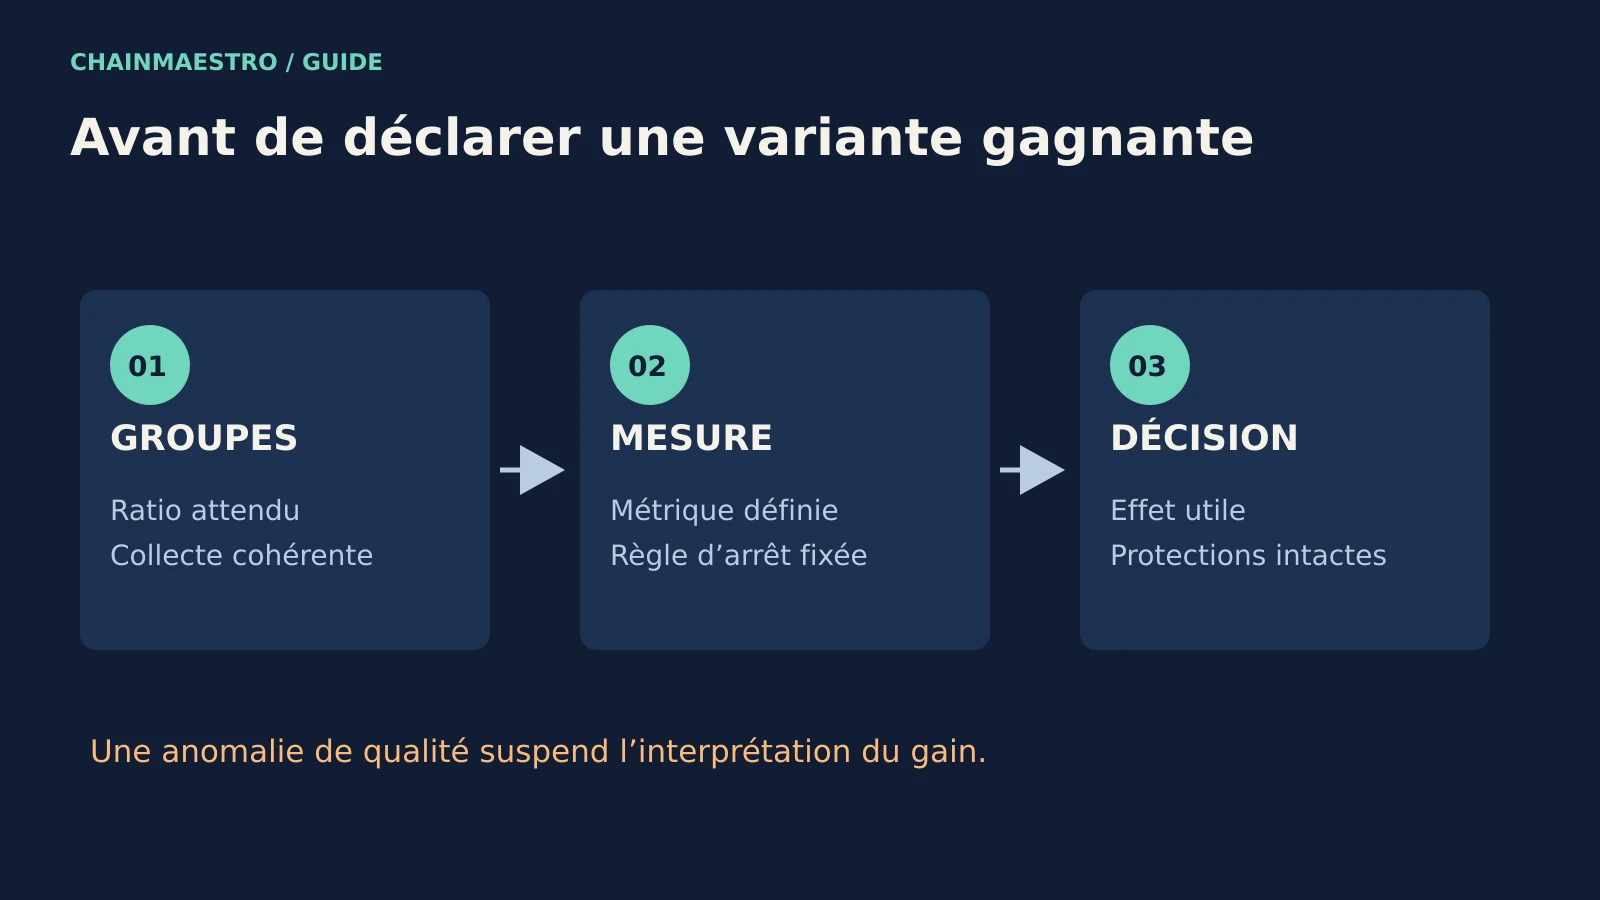
- Un test A/B valide commence par une affectation fiable, une mesure complète et une règle de décision définie avant de regarder les résultats.
- Le contrôle du ratio entre groupes révèle certaines anomalies de collecte ; un écart inexpliqué doit suspendre l’interprétation.
- Un gain statistique peut rester trop faible pour justifier une livraison, et un test inconclusif ne prouve pas l’absence d’effet.
Le nouveau bouton convertit mieux depuis mardi. Jeudi, le graphique devient vert. L’équipe déploie vendredi, puis ne retrouve pas le gain dans les ventes. Un problème de test A/B peut produire exactement cette séquence : sélection d’un moment favorable, collecte différente entre variantes ou métrique trop éloignée du résultat économique.
Une expérience contrôlée ne sert pas à faire approuver une idée par un dashboard. Elle sert à réduire l’incertitude sur une décision précise. Pour y parvenir, l’équipe doit vérifier la qualité du test avant de commenter l’effet mesuré, puis relier cet effet au coût et aux risques du changement.
Écrire la décision avant de lancer le test
Commencer par une hypothèse réfutable. « Simplifier le formulaire augmente le nombre d’inscriptions qualifiées, sans dégrader l’activation » fixe une cible plus nette que « améliorer le tunnel ». Le test doit distinguer la création d’un compte de son utilisation effective. Un champ supprimé peut augmenter le volume tout en attirant des inscriptions inutilisables.
Définir une métrique principale, des indicateurs de protection et un effet minimal qui changerait la décision. Les protections peuvent couvrir erreurs, latence, remboursements ou charge du support. Le choix dépend du parcours et doit être daté avant l’exposition. Multiplier les métriques jusqu’à en trouver une favorable transforme l’analyse en sélection opportuniste.
Les étapes du tunnel de vente donnent des points d’observation utiles, mais chacune n’a pas la même valeur. Choisir un événement dont la définition et le délai sont compatibles avec la durée de l’expérience. Un achat compté avant annulation répond à une autre question qu’un revenu net après remboursement.
Affecter la bonne unité et la conserver
Une répartition par session ne convient pas toujours à un produit utilisé plusieurs fois. La même personne peut voir deux interfaces, apprendre l’une et agir dans l’autre. Selon le cas, l’unité pertinente est l’utilisateur, le compte d’entreprise ou un groupe d’utilisateurs qui interagissent. Il faut choisir ce niveau avant le calcul de taille d’échantillon.
Le compte d’entreprise devient important lorsque des collaborateurs partagent le même paramétrage ou prennent une décision commune. Compter toutes leurs actions comme indépendantes surestime la quantité d’information disponible. L’analyse doit correspondre au niveau d’affectation, avec une méthode adaptée aux dépendances entre observations.
Conserver trois faits distincts : affectation à une variante, exposition réelle à cette variante et événement de résultat. Une affectation sans exposition peut être normale ; une exposition perdue seulement dans un groupe peut biaiser le résultat. Écrire cette distinction dans le schéma d’événements évite bien des explications tardives.
Le ratio de groupes précède la comparaison
Le travail de Microsoft Research sur le Sample Ratio Mismatch décrit un contrôle essentiel : comparer les proportions observées aux proportions prévues. Un écart statistiquement incompatible avec le plan peut signaler un problème de randomisation, de filtre, d’exposition ou de télémétrie. Le résultat commercial ne doit pas être interprété avant d’en comprendre la cause.
Une allocation prévue à 50/50 ne donne pas exactement les mêmes effectifs à chaque instant. Le contrôle doit quantifier l’écart, avec un test adapté, plutôt que sanctionner toute différence brute. Il faut aussi définir la population contrôlée : affectés, exposés et analysés peuvent être différents pour des raisons légitimes ou problématiques.
Un test A/A, qui sert la même expérience aux deux groupes, aide à vérifier l’instrumentation. Il ne garantit pas la validité de toutes les expériences futures : un nouveau parcours peut introduire un événement manquant ou une redirection asymétrique. La qualité doit donc rester surveillée pendant chaque test.
Pourquoi 450 achats contre 400 ne suffisent pas
Considérons un exemple hypothétique. Le tableau montre 450 achats pour B et 400 pour A. L’équipe annonce un gain de 12,5 %. Mais B a reçu 12 000 utilisateurs et A 10 000 : les taux sont respectivement 3,75 % et 4 %. Le gain en nombre brut disparaît ; le taux paraît même plus faible pour B.
Si le plan prévoyait 50/50, cette différence d’effectifs appelle d’abord un diagnostic. Supposez qu’une redirection de la variante A perde une partie des événements d’exposition. Calculer un taux avec ces effectifs ne répare pas l’expérience : le dénominateur lui-même devient incertain. Il faut corriger la collecte et déterminer si les données déjà acquises restent utilisables.
Autre cas : les groupes contiennent chacun 10 000 utilisateurs et B obtient 450 achats contre 400. La différence observée est de 0,5 point de pourcentage, soit 12,5 % relativement au taux de A. Sa précision statistique et sa valeur économique restent à examiner. Un chiffre positif n’indique pas, à lui seul, si le résultat résistera à une nouvelle population.
Regarder chaque matin change la question statistique
Un test conçu pour une analyse à horizon fixe ne peut pas être arrêté au premier résultat favorable sans modifier ses propriétés d’erreur. Une méthode séquentielle peut encadrer des décisions intermédiaires, mais elle doit être choisie et paramétrée à l’avance. Le mot « temps réel » sur une interface ne suffit pas à définir cette méthode.
Il est possible de surveiller les indicateurs de sécurité et la qualité de collecte pendant le test, avec une procédure d’arrêt pour dommage évident. Cela diffère d’une sélection du jour où la métrique principale devient positive. Documenter les deux règles et conserver la trace de tout arrêt anticipé.
La durée doit aussi couvrir le cycle métier pertinent : semaine de travail, délai d’activation ou période de retour. Une expérience courte peut capter un effet de nouveauté ou un comportement de campagne. Fixer uniquement un nombre d’utilisateurs ignore parfois la maturation des résultats.
Interpréter le résultat comme une décision
| Résultat | Lecture utile | Action possible |
|---|---|---|
| Qualité des données douteuse | Effet non interprétable | Corriger, puis refaire le test |
| Gain précis et utile | Hypothèse soutenue sur la population testée | Déployer avec protections suivies |
| Intervalle large | Incertitude encore forte | Revoir puissance ou priorité |
| Petit gain, coût élevé | Succès statistique peu rentable | Comparer à une solution plus simple |
Présenter l’effet absolu, l’effet relatif et un intervalle d’incertitude. Le commentaire doit expliquer la population, la période et les exclusions. « Aucun effet significatif » ne veut pas dire « les variantes sont identiques » : l’étude peut être incapable de détecter un effet pourtant utile au produit.
Segmenter après coup par appareil, canal et pays peut aider à explorer. Les conclusions deviennent plus fragiles quand on teste beaucoup de sous-groupes. Une observation intéressante mérite une nouvelle hypothèse et une expérience dédiée. Notre guide sur les techniques d’optimisation de conversion gagne ainsi à être lu comme un ensemble de pistes à tester, plutôt que comme des gains garantis.
Enfin, relier le résultat à la charge de maintenance. Une variante qui crée trois branches d’interface et une collecte spécifique doit produire une valeur suffisante pour justifier cette complexité. Les données marketing restent utiles lorsque l’équipe conserve la méthode qui a permis de les interpréter.
Pour le prochain test, exigez une fiche d’une page : décision, unité d’affectation, métrique principale, protections, durée et règle d’arrêt. Si cette fiche manque, le lancement est prématuré.
Sources et références
Sources primaires consultées le 1er octobre 2026 : Microsoft Research, diagnostic du ratio d’échantillon et interprétation après expérience. Les cas chiffrés sont hypothétiques ; aucun seuil universel de durée ou de taille n’est proposé.